Второй мозг в Obsidian и Notion: как собрать сетап
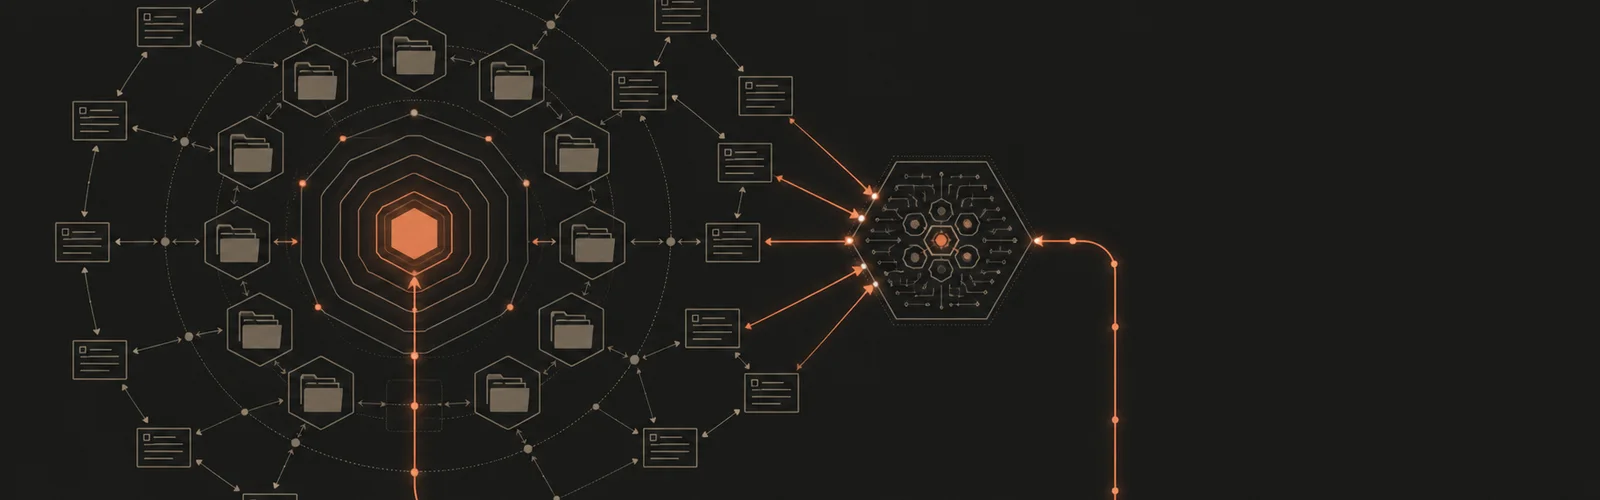
Второй мозг - это внешняя память, куда ты складываешь свои решения, цифры, регламенты и формулировки, чтобы потом дать к ним доступ языковой модели. Собирается он за четыре шага: выбрать инструмент, завести несколько плоских разделов верхнего уровня, связать заметки ссылками и тегами и уже поверх готовой структуры подключить ИИ. Если поменять порядок и начать с модели, получится красивый чат поверх пустоты, который отвечает общими словами.
Свой сетап я собрал далеко не с первого захода. В первой версии было три десятка вложенных папок, я путался, куда класть очередную мысль, и через месяц перестал туда заходить. Пришлось начинать заново, грубее и проще - этот вариант дожил до сегодняшнего дня и потихоньку растёт.
Модель усиливает то, что у тебя уже накоплено, и это лучше принять до начала работы. Дай ей вычищенную базу - в ответах появятся твои цифры, твой тон, твои регламенты; на свалке из случайных файлов получишь усреднённые фразы из интернета, произнесённые увереннее, чем следовало бы. Идею первичности метода задолго до нынешних разговоров про ИИ развернул Тиаго Форте в подходе PARA, и с тех пор она никуда не делась.
Что складывать во второй мозг, а что оставлять снаружи?
Соблазн понятный: раз уж собираешь внешнюю память, хочется затащить туда всё, до чего дотянешься. Экспорт переписок, тысячу сохранённых статей, старые презентации, скриншоты. Через две недели такая база превращается в чердак, по которому невозможно найти ничего осмысленного, а модель, получив к нему доступ, начинает вытаскивать случайный шум вместо ответов.
Фильтр удобно формулировать через возврат: заметка заслуживает места во втором мозге, если ты открываешь её хотя бы раз в пару месяцев и если держать её содержимое в голове дорого. Под это описание попадают принятые решения вместе с причинами, экономика продукта, формулировки, которые уже показали себя в работе, повторяемые процессы и всё, что ты обычно ищешь по переписке, ругаясь на поиск.
Снаружи спокойно остаётся то, что легко нагуглить заново, черновики без выводов, чужие статьи целиком и файлы, которые ты хранишь на всякий случай. Ссылку на интересный материал имеет смысл сопроводить парой строк о том, что именно ты оттуда забрал, иначе через полгода это будет просто синий текст без контекста.
База не обязана описывать твой бизнес целиком, чтобы приносить пользу. Десяток плотных заметок про продукт, аудиторию и тон дают модели больше, чем двести разрозненных файлов, потому что из плотной заметки понятно, что здесь актуально, а куча файлов заставляет её угадывать.
Как выбрать между Obsidian и Notion?
Критерий здесь ровно один: кто будет пользоваться базой. Для личной работы обычно берут Obsidian - он быстрый, файлы лежат у тебя на диске, связи между заметками сделаны родной механикой. Notion сильнее там, где над базой сидит команда: таблицы, статусы, права доступа, комментарии. Колеблешься, а база всё-таки про тебя одного - начинай с Obsidian, подключать модель к обычным текстовым файлам проще всего.
| Критерий | Obsidian | Notion |
|---|---|---|
| Хранение | Локальные markdown-файлы у тебя | Облако Notion |
| Скорость | Мгновенно, работает офлайн | Зависит от сети |
| Связи между заметками | Родная механика ([[ссылки]], граф) | Есть, но слабее |
| Таблицы и статусы | Базово | Сильная сторона |
| Командная работа | Слабо | Сильно |
| Подключение ИИ | Через файлы напрямую, легко | Через API |
Дальше почти всегда всплывает вопрос про запас прочности: что будет, если инструмент перестанет устраивать. Markdown-файлы Obsidian открываются в любом редакторе и переезжают куда угодно без потерь. Экспорт из Notion тоже есть, но связанные базы данных при переезде частично рассыпаются в плоские таблицы, и часть логики придётся собирать руками.
Гибридная схема встречается чаще, чем кажется: личное ядро живёт в Obsidian, командные процессы и таблицы - в Notion, а пересечение между ними держат ссылки. Правило здесь одно: у каждого типа знания есть единственный дом, иначе через месяц ты будешь искать регламент в двух местах и находить две разные версии.
Как собрать каркас, который переживёт первый месяц?
Моя первая структура умерла ровно из-за глубины: чтобы положить мысль на место, приходилось помнить всю иерархию целиком, и мозг быстро выбрал вариант «положу потом». Рабочий каркас держится на плоской схеме из пяти-семи разделов верхнего уровня, где вложенность заканчивается на втором уровне.
Вот каркас, который я держу сам и который одинаково ложится на предпринимателя и на автора контента:
- 00 Входящее - сюда падает всё сырое: мысли, ссылки, обрывки разговоров. Разбираешь раз в неделю.
- 10 Проекты - активные дела, по одной заметке на проект.
- 20 База знаний - цифры бизнеса, продукты, аудитория, тон, регламенты. Это ядро.
- 30 Люди - клиенты, партнёры, подрядчики.
- 40 Ресурсы - шаблоны, промпты, чек-листы.
- 90 Архив - то, что закрыто, но выбрасывать жалко.
Цифры в начале названий удерживают разделы в осмысленном порядке и не дают им прыгать по алфавиту, когда появится раздел на букву «А». Больше ничего изобретать не нужно: структура должна быть настолько тупой, чтобы вопрос «куда это положить» не занимал ни секунды. Как только ты задумался над местом для заметки, ты её уже не положил, а система, в которую перестают класть, перестаёт существовать.
Проекты и базу знаний путают чаще всего, поэтому разведу их явно. Проект - это то, у чего есть срок и финал: запуск, переговоры, съёмка. Всё, что переживёт этот проект и понадобится в следующем, переезжает в базу знаний. Когда проект закрывается, ты вытаскиваешь из него выводы, а оставшийся мусор отправляешь в архив одним движением. Похожий принцип я описывал в разборе про то, с каких задач начинать автоматизацию рутины: сначала выделяешь повторяемое, потом строишь вокруг него систему.
Как связать заметки между собой?
Папка говорит только о том, где заметка лежит. Про то, с чем она перекликается, знают связи, и именно они превращают набор файлов во второй мозг. Три приёма дают почти всю пользу, и осваивать их можно по очереди.
- Ссылки между заметками. В Obsidian это
[[Название заметки]], в Notion -@упоминание. Пишешь про клиента и тут же ссылаешься на его проект, из проекта уходишь на нужный регламент. Через месяц любая заметка открывается вместе с окружающим контекстом, и не приходится вспоминать, где что обсуждалось. - Теги для сквозных срезов.
#оффер,#промпт,#цифрысобирают заметки поперёк папок. Все формулировки офферов оказываются в одном списке независимо от того, в каком проекте они родились. - Заметки-хабы, они же MOC или map of content. Одна заметка-оглавление на крупную тему, куда ты руками складываешь ссылки на важное. Это твоя точка входа вместо слепого поиска по всей базе, и модели такой хаб тоже помогает, потому что даёт ей готовую карту темы.
Ломается всё обычно на тегах. Начинаешь размечать каждую заметку, через месяц получаешь двести тегов, половина из которых встретилась однажды, и разметка перестаёт что-либо значить. Держи пятнадцать-двадцать живых тегов и без сожаления удаляй одноразовые: сквозной срез имеет смысл только тогда, когда в нём набирается хотя бы несколько заметок.
Граф связей в Obsidian красив, но пользы от разглядывания шарика с точками немного. В нём есть один полезный сигнал: заметка, которая висит в стороне от всего, либо забыта при связывании, либо тебе не нужна.
Чем наполнить ядро базы знаний?
Ядро - это те заметки, которые ты будешь скармливать модели чаще всего, поэтому качество здесь важнее объёма. Минимальный набор выглядит так:
- Цифры - ключевые метрики, средний чек, экономика продукта. Всё, что ты обычно ищешь по собственным таблицам.
- Продукты - что ты продаёшь, из чего это состоит, кому и в какой ситуации подходит.
- Аудитория - кто покупает, какими словами описывает свою проблему, какие возражения приносит.
- Тон - как ты говоришь, какие слова используешь, что для тебя недопустимо.
- Регламенты - как делается повторяемая работа: как собирается пост, как обрабатывается возражение, как принимается заявка.
Заметку в ядре имеет смысл писать так, будто объясняешь новому сотруднику, который выходит завтра и ничего о тебе не знает. Модель прочитает ровно то, что написано, и ни буквой больше. Из фразы «пишем в дружелюбном тоне» получится усреднённая вежливость на выходе. Три примера твоих реальных формулировок с пояснением, почему они сработали, дают узнаваемый голос. По сути ты заранее пишешь инструкцию для будущего цифрового сотрудника, и чем точнее регламент, тем меньше в ответах отсебятины.
Хороший тест на готовность заметки: покажи её человеку со стороны и попроси пересказать своими словами. Если он спотыкается на терминах и подразумеваемом контексте, модель споткнётся там же, только вместо вопроса выдаст правдоподобную выдумку. Подробнее про то, как оформлять знания под модель, я разбирал в материале о том, как дать нейросети базу знаний.
Как оформить заметку, чтобы её понял и человек, и модель?
У заметки в ядре есть скучный, но полезный скелет. Сверху идёт заголовок, который читается как утверждение: «Как мы отвечаем на возражение про цену» работает лучше, чем ярлык «Возражения». Дальше одна строка о том, для чего эта заметка нужна и когда к ней возвращаться. Потом основное содержимое, разбитое подзаголовками или списками. В конце - дата последнего обновления и ссылки на смежные заметки.
У списков и подзаголовков есть техническая причина. Когда база подключается через RAG, текст режется на куски: заметка с внятной структурой распадается по смысловым границам, а сплошное полотно на две тысячи слов рвётся посреди мысли, и модель достраивает потерянный контекст сама.
Ещё одна привычка - помечать статус: рабочая версия, черновик, устарело. Устаревшую заметку удобнее пометить и убрать из ядра, чем удалять сразу, потому что старые цены и старые регламенты имеют свойство всплывать в ответах модели в самый неподходящий момент. Ту же логику версий и актуальности я описывал применительно к ИИ-ассистенту для малого бизнеса, где половина проблем с качеством ответов растёт из устаревших данных.
Что делать с тем, что уже накопилось?
Обычно к моменту сборки второго мозга у человека уже есть завалы: заметки в телефоне, документы в облаке, сохранёнки в мессенджере, десяток файлов с названием «важное_финал_2». Тащить это всё разом в новую структуру - самый быстрый способ похоронить систему на старте.
Порядок лучше перевернуть: собери пустой каркас, живи в нём с сегодняшнего дня, а старое переноси по требованию - понадобилось, нашёл, переписал своими словами, положил на место. Через пару недель окажется, что из архива реально пригодилась небольшая часть, а остальное спокойно лежит там, где лежало, и никому не мешает.
Единственное исключение - ядро. Пять-шесть заметок про цифры, продукт, аудиторию и тон имеет смысл написать сразу и целиком, потому что без них модель не сможет отвечать по твоим данным. Это работа на вечер, и она окупается с первого же запроса.
Ещё одна привычка, которая экономит месяцы: после принятого решения записывать не только сам вывод, но и причину. Через полгода ты не вспомнишь, почему отказался от канала или поменял оффер, и заметка без причины превратится в приказ без объяснений, который ты же и нарушишь.
Как подключить ИИ к базе?
Ради этого всё и затевалось. Уровней три, и они честно отличаются по трудозатратам.
Уровень 1. Заметки в контексте. Самый прямой старт: открываешь нужные файлы, вставляешь их текст в чат и формулируешь задачу примерно так - «вот моя база знаний по продукту и тону, опираясь только на неё, напиши пост». Ключевое здесь «только на неё». Настраивать ничего не надо, результат виден с первого ответа, отдельных расходов нет. Минус в ручном труде: заметки таскаешь сам, и объём контекста ограничен. Для многих задач этого хватает надолго, особенно если сложить ядро в один файл и держать его под рукой. Как выжимать максимум из такого формата, я разбирал на примере Claude и его работы с длинным контекстом.
Уровень 2. Модель внутри инструмента. У Notion есть встроенный ИИ, у Obsidian - плагины, которые подключают модель по API или к локально запущенной модели. Ассистент видит твои заметки и отвечает по ним без копипаста. Удобно для быстрых вопросов вроде «что у меня записано про этого клиента» и для черновиков прямо в рабочем окне.
Уровень 3. RAG, то есть поиск по базе. База становится источником, из которого модель достаёт нужное сама. Заметки режутся на куски, куски прогоняются через эмбеддинги и складываются в векторное хранилище. На каждый вопрос система сначала находит несколько релевантных фрагментов, потом отдаёт их модели вместе с вопросом. Так устроены рабочие ИИ-агенты для бизнеса, которые не грузят всю базу целиком, а вытаскивают только нужное под конкретный запрос. Отсюда и берётся ощущение, что второй мозг помнит всё.
Практическая деталь, о которую спотыкаются на старте, - размер куска. Мелкие фрагменты теряют контекст вокруг мысли; куски размером с половину заметки затаскивают в ответ лишнее и съедают лимит. Для обычных заметок на пару экранов разумно резать по несколько сотен слов с небольшим перекрытием, чтобы фраза на границе не пропадала. К каждому куску полезно прикладывать название заметки и дату обновления: тогда модель может сослаться на источник, а ты сразу видишь, не пришёл ли ответ из позапрошлогоднего файла.
Собирать третий уровень руками необязательно. Связку «папка с заметками - векторное хранилище - чат» удобно поднимать в визуальных конструкторах, и если ты идёшь этим путём, полезно сначала посмотреть, как освоить n8n с нуля. Тем, кому ближе код, хватит скрипта на пару экранов, и про этот вариант есть отдельный разбор о том, что реально автоматизируется на Python.
Как отучить модель выдумывать твои детали?
Одна инструкция закрывает большую часть проблем с придуманными фактами:
«Отвечай только по приложенным заметкам. Если информации в них нет, так и напиши: в базе этого нет. Не додумывай цифры и факты».
Она снимает главную беду, когда модель уверенно сочиняет твою выручку или состав продукта, которых ты ей не давал. Вторая половина решения - попросить указывать источник: из какой заметки взят каждый тезис. Тогда сомнительная цифра проверяется за несколько секунд, вместо того чтобы уходить клиенту как есть.
Дальше работает дисциплина запроса. Чем конкретнее вопрос, тем меньше места для фантазии. Формулировка «сравни два оффера из заметки Продукты по цене и обещанию» даёт проверяемый ответ. От «расскажи про наши продукты» жди общих слов, слегка разбавленных твоими фрагментами. Хорошая тренировка формулировок описана в материале про то, какие вопросы задавать ИИ в бизнес-аналитике.
С границей возможностей лучше договориться заранее. Модель отлично собирает черновик по твоей базе и находит противоречия между заметками, при этом она понятия не имеет, что изменилось вчера в переговорах и о чём вы условились голосом. Всё, что не записано, для неё не существует.
Как проверить, что сетап рабочий?
Проверять надо пользу, а красота графа тут ни при чём. Три теста дают понятную картину.
- Тест возврата. Задай модели вопрос по своей базе: какой у нас тон в постах, что мы обещаем клиенту, из чего состоит продукт. Совпадение ответа с тем, что записано, означает, что база читается и подключена правильно.
- Тест честности. Спроси то, чего в базе заведомо нет. Ответ «в базе этого нет» означает, что инструкция работает. Если вместо этого пошла складная выдумка, усиливай формулировку из предыдущего раздела или проверяй, действительно ли заметки попали в контекст.
- Тест недели. Через неделю открой раздел «Входящее». Заметки, которые ты туда положил и потом разобрал, говорят о живой системе. Пустой раздел при разбежавшихся по мессенджерам и стикерам мыслях означает, что структура оказалась слишком сложной для твоего темпа, и упрощать её надо дальше.
Четвёртый тест появляется позже, когда база подрастёт: попроси модель найти противоречия между заметками. Обычно всплывает пара мест, где старая цена спорит с новой или регламент расходится с тем, как ты работаешь на самом деле. Это самый дешёвый способ навести порядок.
Что ломается через месяц и как это чинить?
Первым переполняется «Входящее». Помогает здесь календарь: полчаса раз в неделю на разбор плюс правило, что необработанная мысль либо превращается в заметку, либо удаляется. Хранить сырое дольше недели смысла нет, потому что контекст выветривается и заметка становится нечитаемой даже для автора.
Следом расползаются теги, и лечит их регулярная чистка одноразовых. Дальше идут дубли: одна и та же мысль записана трижды в разных формулировках, и модель выдаёт то одну версию, то другую. Помогают ссылки вместо копирования, когда одна заметка остаётся источником, а остальные на неё указывают.
Самая тихая поломка - база перестаёт обновляться после решений. Ты поменял цену, договорился о новых условиях, переписал оффер, а в заметках всё по-старому. Через два месяца модель начинает вежливо транслировать прошлое, и доверие к сетапу рушится. Спасает привычка закрывать любое решение записью в тот же день, хотя бы в три строки.
Последняя ловушка - желание переехать на новый инструмент, как только что-то заскрипело. Скрипит обычно привычка, инструмент тут почти всегда ни при чём, а переезд просто переносит беспорядок на новое место с ощущением бурной деятельности.
Сколько это стоит по времени и деньгам?
По времени первый каркас занимает вечер: полчаса на выбор инструмента, час на структуру и остаток на пять-шесть заметок ядра. Дальше база растёт по ходу работы, и отдельного бюджета времени на неё почти не уходит, если не считать еженедельного разбора входящего.
По деньгам первый уровень бесплатен полностью. Obsidian для личного использования денег не просит, платить приходится только за фирменную синхронизацию между устройствами, и её несложно заменить обычным облачным диском. У Notion есть бесплатный тариф для личных задач, а расходы начинаются на командных планах и на встроенном ИИ. Второй и третий уровни добавляют оплату за обращения к модели по факту использования, и для личной базы суммы получаются скромными, потому что запросов немного.
Настоящая стоимость сидит в другом месте. Дорого обходится решение о том, стоит ли вообще строить систему под задачу или дешевле оставить всё как есть, и на эту тему у меня есть отдельный честный разбор про то, когда ИИ дороже живого сотрудника.
Какие возражения звучат чаще всего?
«У меня и так всё в голове». Пока задач немного, это правда работает. Проблема вылезает в момент делегирования: подрядчику или модели нужно передать контекст, а он существует только в виде твоей интуиции, и передача превращается в многочасовой разговор с пересказом одного и того же.
«Я не буду это вести, я себя знаю». Ведение упирается в стоимость одного действия. Когда мысль кладётся одним движением в уже открытое приложение, привычка приживается сама собой. Иерархия из пяти уровней убивает её на второй неделе - дело в структуре, которую ты сам себе построил.
«Проще спрашивать модель без всякой базы». Без базы модель отвечает усреднённо по интернету, и для общих вопросов этого достаточно. Как только речь заходит о твоих цифрах, твоём продукте и твоих формулировках, начинается угадывание, и проверять такие ответы дольше, чем написать самому.
«Это всё для тех, кто пишет тексты». Второй мозг одинаково полезен там, где есть повторяемые процессы и накопленный контекст: продажи, найм, производство, поддержка. Карту таких сценариев я собирал в обзоре автоматизации бизнес-процессов с ИИ.
«Заведу сразу агента, он сам всё разложит». Агент разложит ровно то, что ему дали, и на пустой базе превратится в генератор правдоподобного текста. Разница между сборкой своими руками и готовым решением подробно разобрана в материале про ИИ-агентов под ключ и сборку самому.
Где всё равно нужен человек?
Модель снимает рутину: находит нужную заметку, собирает черновик по твоей базе, помнит то, что ты сам забыл записать месяц назад. Дальше начинается зона, где ответственность не делегируется. Решение о том, что важно, а что уходит в архив, остаётся за тобой, фальшь в тоне тоже слышишь только ты. Цифру в коммерческом предложении подписывает человек, и ссылка на источник от этой подписи не освобождает.
Есть и более тонкий момент. База отражает то, как ты думал в момент записи, и часть заметок устаревает раньше, чем ты успеваешь это заметить. Пересмотр ядра раз в квартал обходится дешевле, чем разбор последствий уверенного ответа по прошлогодним данным. Похожие ограничения я разбирал в тексте о том, миф ли цифровой двойник сотрудника.
С чего начать на этой неделе?
Выбери инструмент по единственному критерию из второго раздела, заведи шесть папок верхнего уровня и напиши пять заметок ядра про цифры, продукт, аудиторию, тон и один регламент. Вечером того же дня скопируй эти пять заметок в чат с моделью, добавь инструкцию про ответ только по приложенному и попроси собрать что-нибудь рабочее: пост, ответ клиенту, описание услуги. Разница с ответом без базы видна с первого раза.
Дальше расширяй по мере необходимости: связи, теги, хабы, потом подключение через RAG. Пошаговую сборку помощника поверх такой базы я расписывал отдельно в материале про то, как собрать ИИ-сотрудника с нуля.
Если хочешь пройти этот путь с опорой на готовую программу, у меня есть бесплатное обучение по ИИ в ИИмперии - там разобраны и база знаний, и подключение моделей к своим данным. А текущие эксперименты с сетапами я выкладываю в закрытом канале ИИмперии.
Самое любопытное начинается в тот день, когда ты впервые открываешь модели доступ к собственной голове и смотришь, что она там найдёт.
Источники
Частые вопросы
Obsidian или Notion - что выбрать?
Ответ зависит от того, кто будет пользоваться базой. Личный архив с быстрым поиском, локальными файлами и плотными связями удобнее вести в Obsidian. Когда над базой работает команда и нужны таблицы, статусы и совместный доступ, задачу лучше закрывает Notion.
Нужно ли переносить вообще всё в один инструмент?
Всё подряд тащить не надо. Во второй мозг попадает то, к чему ты возвращаешься по несколько раз: решения с причинами, регламенты, цифры, формулировки. Архив переписок и случайные файлы пусть остаются там, где лежат.
ИИ будет отвечать по моей базе или всё равно выдумает?
По базе модель отвечает тогда, когда заметки физически попали к ней в контекст: ты вставил их руками или настроил поиск через RAG. Без этого шага она соберёт ответ из общих знаний и допишет недостающие детали от себя.
Сколько времени занимает первый рабочий сетап?
Каркас из папок и десятка ключевых заметок собирается за вечер или два. Дальше база растёт по ходу работы, отдельный марафон на её наполнение не нужен.