База знаний для нейросети: как дать ИИ память по твоим данным
База знаний для нейросети - это твои документы, уложенные так, чтобы модель брала оттуда факты: продукты, цены, регламенты, тон разговора. Механика короткая: собираешь чистый набор материалов, кладёшь его туда, откуда модель умеет читать, и прямым правилом отсекаешь ответы мимо источников.
Понадобилось мне это после того, как я в очередной раз поймал модель на вранье про собственный тариф. Спросил, что входит в пакет, и получил бодрый ответ с ценой, которой у меня никогда не было. Модель не хитрила: ей нечем было ответить, и она собрала связный текст из того, что видела у других. Дальше начинается вилка: вставлять текст в промпт руками или строить систему, которая сама достаёт нужный кусок под вопрос. Дальше по тексту оба пути, устройство поиска изнутри и способ убедиться, что штука работает за пределами демо.
Почему нейросеть уверенно врёт про твой бизнес?
Модель училась на публичных текстах и обрывается на дате отсечки. Внутри неё нет твоего прайса, твоих регламентов и вчерашнего разговора с клиентом. Когда ты спрашиваешь про состав пакета, она достаёт из своего опыта тысячи чужих прайсов и собирает из них правдоподобный. Отдельного сигнала «этот факт я проверил» у неё нет: и точный ответ, и выдумка рождаются одним и тем же способом, предсказанием следующего куска текста. Уверенный тон достаётся обоим бесплатно.
Отсюда следствие, из которого растёт вся дальнейшая работа: качество ответа задаётся тем, что лежит у модели перед глазами в момент запроса. При пустом контексте получается красивый текст с выдуманной фактурой, а положенный туда настоящий регламент сразу делает ответ проверяемым.
Цена ошибки зависит от того, кому уходит результат. Пока я сам сижу в чате, враньё ловится за секунду. Хуже, если тот же ответ ушёл клиенту в переписку или лёг в отчёт, который я потом показываю партнёру: ловить уже поздно. Именно поэтому база знаний перестаёт быть удобством и становится условием, при котором ИИ вообще можно подпускать к внешнему контуру.
Здесь и проходит граница между случайным помощником и цифровым сотрудником. У сотрудника есть источник фактов, регламент действий и запрет отвечать наугад. Помощник из коробки владеет только красноречием, и до определённого момента этого хватает, пока ты не начинаешь спрашивать про свои цифры.
Про промпт нужно сказать отдельно, потому что на него списывают почти всё. Люди месяцами шлифуют формулировки, надеясь вылечить враньё подбором слов. Промпт влияет на форму ответа и на то, насколько аккуратно модель обходится с неизвестным, но саму цифру он из воздуха не достанет. Дальше промпта начинается работа с данными.
Какая память бывает у нейросети?
Слово «память» покрывает четыре разные вещи, и путаница между ними стоит людям недель.
Ближе всего лежит окно контекста, то есть всё, что ты положил в текущий разговор. Работает мгновенно, стоит токенов, исчезает вместе с чатом. Ты им уже пользуешься, когда копируешь кусок регламента в переписку с моделью. Современные модели держат в окне десятки и сотни тысяч токенов, из-за чего многие задачи закрываются без всякой инфраструктуры: у Claude длинный контекст спокойно проглатывает целый свод регламентов небольшой компании.
Рядом живёт встроенная «память» чат-сервисов, копящая заметки о тебе между сессиями. Для привычек и тона она удобна, а вот в фактуре я на неё не полагаюсь: ты не управляешь тем, что туда попало, и не видишь, откуда взялся конкретный вывод.
Третьим идёт внешнее хранилище документов с поиском. Система держит материалы у себя, под каждый вопрос достаёт релевантные куски и подкладывает их модели. Объём здесь ограничен только диском, обновление занимает секунды, источник каждого ответа виден.
Последний слой - веса самой модели, которые меняются дообучением. Дообучение задаёт манеру, формат и стиль, а факты в нём живут плохо: любое изменение цены превращается в новый цикл обучения.
Я сам долго читал не туда, считая, что фактуру вшивают именно дообучением. Ошибка типовая. Знание конкретной цены на сегодня хранится в базе, к которой модель обращается во время ответа, и на этом слое закрывается почти всё, что нужно бизнесу.
Что класть в базу знаний?
Начал я с листа бумаги: выписал вопросы, на которые модель должна отвечать без меня. Сначала те, что задают клиенты в переписках, прямо их формулировками, без причёсывания; потом те, которые я сам себе объясняю по десять раз, садясь писать или считать. Получился список, где напротив каждого вопроса видно, какого документа не хватает. Инструмент я подбирал уже под этот список.
Минимальный набор для бизнеса выглядит так:
- Продукты и цены. Что продаёшь, за сколько, что входит в каждый пакет, чем тарифы отличаются между собой, какие бывают скидки и при каких условиях. Из этого блока растёт основная масса вопросов.
- Регламенты и сценарии. Порядок действий при возврате, ответы на типовые возражения, правила эскалации, что делать при жалобе. Здесь же живут границы: чего сотрудник не обещает клиенту никогда.
- Позиционирование и тон. Кто мы, для кого работаем, какими словами говорим, какие формулировки под запретом. Без этого блока модель отвечает вежливым нейтральным голосом из ниоткуда, и текст выдаёт себя с первой строки.
- Факты и цифры бизнеса. Аудитория, ключевые метрики, сезонность, ограничения по мощности. Этот материал нужен, когда ты подключаешь ИИ для бизнес-аналитики и хочешь, чтобы выводы стояли на реальных числах.
- Частые вопросы клиентов. Живые формулировки из переписок работают лучше причёсанного FAQ, потому что это язык, которым спрашивают на самом деле.
Правило отбора у меня одно: если по документу нельзя дать конкретный ответ на конкретный вопрос из списка, он в базу не идёт. Красивая презентация с картинками полезна человеку и бесполезна модели. Из таких файлов я вытаскиваю три абзаца сути и кладу только их.
Пишутся документы для базы иначе, чем для человека. Отсылки вроде «как описано выше» ломают ответ, когда фрагмент вырывают из середины файла: модель видит кусок отдельно и восстановить ссылку не может. Поэтому в каждом абзаце предмет называется полным именем, вместо «он стоит столько-то» пишу «Тариф Pro стоит столько-то». Выглядит топорно при чтении подряд, зато любой вырванный абзац остаётся понятным.
Стартовать разумно с малого. Пять-семь коротких файлов, закрывающих самые горячие вопросы, дают больше пользы, чем выгрузка всего диска. Дальше база растёт от промахов: каждый раз, когда модель не смогла ответить, ты дописываешь недостающий кусок. Такой цикл особенно хорошо ложится на задачи малого бизнеса, где нет отдела, который будет год описывать процессы.
Почему мусор в базе дороже пробела?
Соблазн загрузить всё «на всякий случай» понятен и вреден. Каждый лишний документ разбавляет сигнал: поиск начинает вытаскивать посторонние куски, модель послушно отвечает по ним, и ты получаешь уверенное враньё со ссылкой на источник.
За бортом у меня остаются черновики и промежуточные версии, потому что пометку «набросок» в шапке файла модель не считывает и цитирует такой текст наравне с утверждённым регламентом. Переписки целиком тоже не годятся: из них имеет смысл вытащить формулировки вопросов и рабочие ответы, а разговоры про сроки и погоду выбросить. Сканы и PDF со сложной вёрсткой, где текст лежит картинкой, дают на выходе кашу из обрывков. Из многостраничного отчёта я беру две нужные таблицы и оставляю остальное снаружи. Личные данные клиентов в базу для открытого сценария вроде бота на сайте не попадают вообще.
Отдельная беда - противоречия. Две версии прайса в базе хуже, чем полное отсутствие прайса. При пробеле модель хотя бы способна сказать «данных нет», а при конфликте она выбирает один из вариантов и защищает его аргументами. Я потратил вечер, разбираясь, почему ассистент называет старую цену, пока не нашёл в базе документ годичной давности с похожим заголовком.
Полезная привычка - помечать в каждом файле дату актуальности прямо в тексте, первой строкой. Модель видит эту строку вместе с содержимым и способна оговориться, что данные на такое-то число. Заодно тебе самому проще проводить ревизию.
Как собрать базу знаний по шагам?
Порядок, к которому я пришёл после нескольких заходов:
- Собери исходники в одном месте. Выгрузи всё нужное в отдельную папку: тексты, регламенты, выгрузки переписок, таблицы. Пока без разбора, чтобы увидеть объём.
- Почисти от лишнего. Убери устаревшее, дубли и конфликты. Если в двух файлах разная цена, оставь актуальную и удали вторую.
- Переведи в чистый текст. Приведи материалы к обычному тексту или markdown. Таблицы разверни в текст или оставь простыми, без объединённых ячеек. Один файл - одна тема.
- Разбей на короткие куски. Длинную простыню порежь на смысловые блоки с понятными заголовками, по одной мысли на блок.
- Подпиши каждый кусок. В начале блока поставь строчку о его содержании: «Тариф Pro: состав, цена, для кого». Поиск цепляется за такую строчку куда охотнее, чем за случайный абзац в середине.
- Задай правило поведения. В системном промпте пропиши прямо: отвечай только по предоставленным документам, при отсутствии данных сообщай об этом и предлагай уточнить, ссылайся на источник каждого факта.
- Прогони контрольные вопросы. Возьми тот самый первый список и проверь ответы по документам, прежде чем подпускать систему к живым задачам.
Первые три шага занимают больше времени, чем кажется, и именно они определяют результат. Загрузка файлов в готовый сервис - дело пяти минут, а разбор архива вполне может съесть выходные. Зато потом обновление превращается в замену одного короткого файла.
Если ты уже строишь автоматизацию процессов, удобно повесить обновление базы на тот же контур: правка в исходной таблице тянет за собой перезапись документа и переиндексацию. Тогда база живёт синхронно с бизнесом без ручных телодвижений.
Какой размер куска нужен, чтобы поиск попадал в цель?
Нарезка решает судьбу всей затеи. Поиск работает на уровне фрагмента, до целого файла он не добирается: какой кусок нашёлся, такой ответ ты и увидишь.
Ориентир по размеру - от абзаца до полутора страниц, примерно 300-800 слов. Мелкий кусок теряет контекст, фраза «входит в базовый пакет» без названия тарифа бесполезна. У крупного размывается смысл, и поиск перестаёт различать соседние темы внутри одного файла.
Резать лучше по смысловым границам: раздел, подраздел, отдельный сценарий. Механическая нарезка каждые тысячу символов рвёт предложения пополам и разносит вопрос и ответ по разным фрагментам. Многие инструменты поддерживают перекрытие соседних кусков на пару предложений, и это дешёвый способ не потерять мысль на стыке.
Каждому фрагменту полезно дать шапку с контекстом: название документа, раздел, дата актуальности, тип материала. Anthropic описывал приём, при котором к каждому куску дописывают короткое пояснение о его месте в документе, и точность поиска заметно растёт. Работает это по понятной причине: фрагмент перестаёт быть вырванной цитатой и несёт в себе достаточно, чтобы модель поняла, о чём речь.
Таблицы требуют отдельного обращения. Матрица тарифов, разрезанная поперёк, превращается в кашу из чисел без заголовков. Я разворачиваю такие таблицы в текстовые описания по строкам: «Тариф Pro: столько-то в месяц, включает то-то, лимит такой-то». Получается длиннее, зато каждый кусок читается сам по себе.
Как работает RAG под капотом?
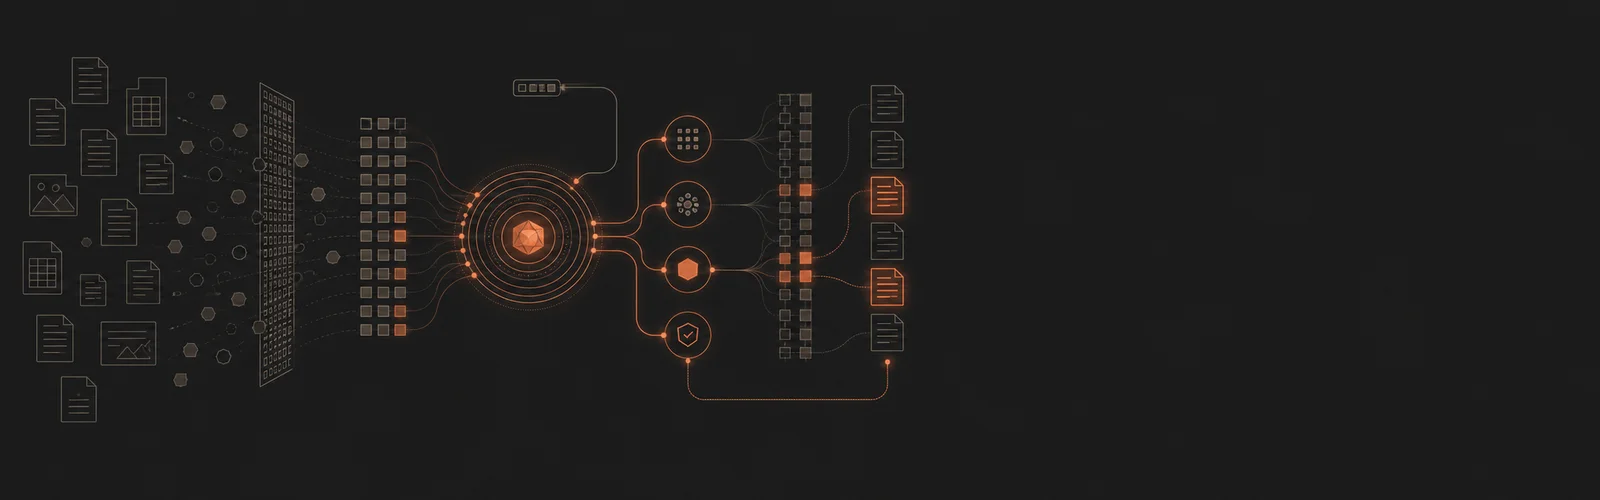
RAG расшифровывается как Retrieval-Augmented Generation, генерация с дополнением поиском. Подход описали в исследовательской работе в 2020 году, и с тех пор он стал рабочим стандартом для задач, где ответ должен опираться на конкретные документы.
Механика распадается на два такта. Сначала система получает вопрос и ищет по твоей базе релевантные фрагменты. Затем найденное отправляется модели вместе с исходным вопросом и инструкцией отвечать по приложенным материалам. Модель формулирует ответ, опираясь на подложенный текст, и собственные догадки в нём почти не участвуют.
Поиск чаще всего работает на эмбеддингах. Каждый фрагмент прогоняют через специальную модель, которая превращает текст в длинный набор чисел, отражающих смысл. Числа складывают в векторную базу. Приходит вопрос - его превращают в такой же набор чисел и ищут ближайшие по смыслу фрагменты. Благодаря этому ответ находится, даже когда клиент спрашивает совсем другими словами: «сколько стоит подписка» находит документ про тарифы, где слова «стоит» нет вовсе.
У смыслового поиска есть слабое место: он плохо ловит точные обозначения вроде артикулов, кодов ошибок и названий моделей. Лечится это гибридным поиском, когда параллельно работает обычный поиск по словам, а результаты двух списков объединяются. Следующий уровень - переранжирование, когда отобранные два десятка кандидатов прогоняют через отдельную модель, оценивающую соответствие вопросу, и модели отдают только лучшие три-пять.
Сколько кусков подкладывать, решается опытом. Один фрагмент часто не покрывает вопрос, десять раздувают запрос и рассеивают внимание модели. Начинаю обычно с трёх-пяти и смотрю по контрольным вопросам, где система промахивается. Задержка и цена тут тоже участвуют в разговоре: сам поиск добавляет доли секунды, а вот подложенные фрагменты уходят в запрос обычным текстом и оплачиваются как токены. Пять здоровых кусков на каждый вопрос стоят ощутимо дороже одного точного, поэтому переранжирование окупается дважды - и качеством ответа, и счётом за обращения.
Готовые сервисы прячут всю эту кухню за загрузкой файлов, и для старта такого уровня контроля хватает. Собственная сборка нужна, когда важны доступы, логи обращений и своя логика поиска. Промежуточный вариант - собрать связку в визуальном конструкторе: освоить n8n с нуля реально за несколько вечеров, и этого достаточно, чтобы подключить хранилище к боту и почте без написания кода.
С чего началась моя первая база знаний?
Первым делом я собрал ассистента, который отвечает на вопросы про мои же продукты. Исходников набралось прилично: тексты с сайта, куски переписок, описания пакетов сразу в трёх местах и презентация, которую никто никогда не дочитывал.
Разбор занял два вечера, и почти всё время ушло на сверку версий. Состав пакета на сайте и в презентации расходился в одном пункте, а какая версия свежая, по самим файлам понять было нельзя; выручила переписка, где я обсуждал это изменение с клиентом. После сверки осталось шесть файлов: продукты и состав пакетов, порядок работы и сроки, ответы на типовые возражения, тон с запретными формулировками, короткая справка о том, кому это подходит, и живой FAQ из переписок.
Первый прогон контрольных вопросов ассистент завалил в двух местах. Про сроки он отвечал общей фразой, потому что сроки лежали внутри длинного абзаца про процесс; я вынес их отдельным блоком с заголовком, и поиск начал их находить. На вопросе про рассрочку он выдумал условия, которых у меня нет: в базе про рассрочку не было ни слова, а запрет отвечать вне источников я тогда в промпт не вписал. После правки промпта модель на тот же вопрос стала честно отправлять к живому человеку.
Дальше база росла только от промахов. Каждый вопрос, на котором ассистент споткнулся, я записывал в отдельный файл, а раз в неделю превращал накопленное в короткие абзацы. Через месяц поток промахов почти иссяк, а сама база прибавила пару страниц, заметно меньше, чем я ожидал вначале. Логика тут ровно та же, что при выборе, с каких задач начинать автоматизацию рутины: берёшь то, что болит чаще всего, и не трогаешь остальное до появления повода.
RAG, дообучение или кастомный GPT: что выбрать?
| Подход | Что делает | Когда не подходит |
|---|---|---|
| Текст в промпте | Вставляешь нужный документ прямо в запрос | Документов много, всё не влезает в контекст |
| Кастомный GPT или ассистент с файлами | Загружаешь файлы в готовый сервис, он ищет по ним сам | Нужен контроль над логикой поиска и доступами |
| RAG на векторной базе | Система достаёт релевантные куски под каждый вопрос | Совсем маленькая база, где усложнение не окупается |
| Дообучение модели | Меняет манеру, формат и стиль ответов | Требуется обновлять фактуру: цены, регламенты, сроки |
Выбор упирается в два вопроса: как часто меняются данные и кто их читает. Всё, что меняется, живёт во внешней базе, потому что правка там занимает минуту. К дообучению я иду только за устойчивой манерой речи и жёстким форматом вывода, да и то после того, как промптом добиться не вышло.
Когда встаёт развилка взять готовое решение или собрать самому, для базы знаний я почти всегда выбираю сборку на готовых кубиках. Данные тут твои, меняются постоянно, и отдавать этот кусок наружу означает потом ходить к подрядчику за каждой правкой цены.
Есть ещё сценарий, о котором забывают: подключить модель напрямую к живой системе через инструменты. Остатки на складе и статус заказа разумнее тянуть запросом в базу данных, чем хранить выгрузкой в документах. Так работают ИИ-агенты, и база знаний в такой схеме держит стабильную часть: регламенты, продукты, тон.
Чем проверить, что модель отвечает по базе?
Проверка сводится к прогону вопросов, на которые ты сам знаешь точный ответ, со сверкой по документу. Смотрю я на две вещи: совпал ли факт и показала ли система, откуда его взяла. Степень уверенности в голосе меня не занимает, ею как раз маскируется выдумка.
Вопросы беру трёх типов. Часть закрыта документами напрямую, и здесь интересно, дотягивается ли поиск до нужного куска. Ещё несколько сознательно бьют в пробел, чтобы увидеть, признается модель в незнании или начнёт сочинять. Третьим заходом идут ловушки с ложной посылкой вроде «почему у вас подорожал тариф», когда цена не менялась; тут сразу видно, поправит система вопрос или подхватит враньё и полезет его обосновывать.
Хороший ответ выглядит как конкретный факт плюс указание источника. Правильный ответ без источника я считаю тревожным звонком: модель могла угадать, и в следующий раз угадает мимо. Настраивать систему на возврат исходных фрагментов стоит с самого начала. То же требование прозрачности я предъявляю к чат-боту для бизнеса: клиенту нельзя отдавать ответы, которые невозможно отследить.
Набор контрольных вопросов удобно сохранить отдельным файлом и прогонять после каждого крупного обновления базы. Это дешёвая страховка от ситуации, когда новый документ ломает ответы, работавшие месяц.
Человека я оставляю в трёх точках: решить, какие данные вообще попадают в базу, разобрать спорную ситуацию, взять ответственность за то, что ушло клиенту. Система достаёт и формулирует, границы правды определяю я.
Что ломается через месяц?
Собранная база выглядит законченной работой ровно до первой недели эксплуатации. Дальше начинается жизнь.
Раньше всего всплывают обновления. Цена поменялась, документ остался. Лечится назначенным владельцем базы и коротким правилом: любое изменение, влияющее на ответы клиентам, доезжает до базы в тот же день.
Следом приходит разрастание. База пухнет, поиск начинает вытаскивать посторонние куски, качество ответов ползёт вниз. Помогает ревизия раз в квартал: пройтись по списку документов и выкинуть то, что перестало отвечать на живые вопросы.
Отдельная головная боль - доступы. Материалы для внутренней команды и материалы для клиентского бота живут в разных наборах, иначе рано или поздно бот процитирует внутреннюю переписку про скидочные условия для крупного партнёра. Разделять лучше сразу, задним числом это делается вдвое дольше.
Про логи вспоминают последними. Без записи вопросов и выданных фрагментов ты не понимаешь, где система мажет. Пара часов чтения логов за неделю даёт больше пользы, чем месяц теоретических улучшений промпта.
Разговор про поддержку упирается в честную экономику. Базу нужно вести, и время на это уходит регулярно. Считать выгоду имеет смысл вместе со всеми издержками, как в разборе про то, когда ИИ дороже живого сотрудника. Для повторяющихся вопросов расклад сходится почти всегда, для редких и сложных - далеко не везде.
Разложить эту работу по шагам помогает бесплатный курс в личном кабинете: пошаговый разбор в бесплатном обучении проводит от первого списка вопросов до собранной базы, с которой уже работает роль.
Какие возражения я слышу чаще всего?
«У меня десять документов, зачем городить систему». При таком объёме городить действительно нечего: сложи материалы в один файл и вставляй его в промпт. Порог наступает там, где ручное копирование начинает раздражать, обычно когда счёт документов пошёл на десятки.
«Модель всё равно врёт, я пробовал». При разборе почти всегда всплывает одно из трёх: в базе конфликт версий, документы залиты сканами, промпт не содержит запрета отвечать вне источников. Проверь эти три пункта, прежде чем списывать подход.
«Без программиста не справлюсь». Готовые сервисы с загрузкой файлов закрывают старт без единой строки кода. Разработка нужна на этапе, когда база вшивается в продукт, требует разграничения доступов и логирования. Само по себе понимание того, какие задачи закрывает ИИ-ассистент, обычно важнее выбора технологии.
«Данные утекут». Вопрос решается выбором площадки и разделением наборов. Чувствительные материалы держатся в закрытом контуре с ограниченным доступом, публичные сценарии работают на отдельной базе. Условия обработки данных у поставщика читаются один раз перед стартом.
«Проще нанять человека». Человек и база решают разные части задачи. Живой сотрудник разбирается в новом и берёт ответственность, система снимает повторяющиеся вопросы, у которых ответ уже записан. Идея заменить человека целиком разбивается о ту же стену, что и цифровой двойник сотрудника: память переносится, суждение остаётся при живом.
«Начну, когда наведу порядок в документах». Порядок наводится в процессе. Возьми пять горячих вопросов, собери под них короткие файлы, запусти и дальше расширяй базу по промахам. Ожидание идеального архива откладывает старт на бесконечность.
Что дальше: как одна база превращается в Empire Brain?
Одна база под один чат - нормальный первый шаг, с него я и начал. Дальше она перестаёт помещаться в роль личной шпаргалки: в Empire Brain общая память обслуживает всех цифровых сотрудников бизнеса сразу, от продавца до аналитика и копирайтера. Каждая роль берёт цифры, продукты, аудиторию и тон из общего контура и перестаёт выспрашивать их у тебя по десятому разу.
Меняется главное свойство. База превращается из папки файлов в живой слой: обновил цену в одном месте - её видят все роли, а новый регламент подхватывают и продавец в переписке, и ассистент в задаче. Новый инструмент в такую систему встаёт быстрее, потому что память под ним уже собрана, остаётся подключить.
Строится это постепенно. Сначала одна роль на одной базе, потом сборка ИИ-сотрудника с нуля и его подключение к общему хранилищу, потом следующая роль на той же памяти. Знание копится в одном месте, команда ролей вокруг него расширяется под задачи, и каждая новая роль обходится дешевле предыдущей.
Начать имеет смысл сегодня, с чистого листа и списка вопросов. Пошаговую сборку я разложил в бесплатном обучении ИИмперии, а готовые связки, промпты и шаблоны ролей разбираю в закрытом канале ИИмперии.
Источники
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020) - исходная работа, где сформулирован подход RAG.
- OpenAI: руководство по эмбеддингам - как текст превращается в векторы для поиска по смыслу.
- Anthropic: Contextual Retrieval - как поднять точность поиска через контекстные подписи к фрагментам.
Частые вопросы
Обязательно ли делать RAG, или хватит вставить текст в промпт?
Пока весь нужный материал влезает в окно контекста и умещается в бюджет токенов, хватает промпта. RAG нужен, когда документов десятки и модель должна сама находить релевантный кусок.
В каком формате хранить документы для базы знаний?
В чистом тексте или markdown, без сложной вёрстки, таблиц-картинок и сканов. Модель читает текст и спотыкается на макете, поэтому лишнее оформление только мешает.
Как часто обновлять базу знаний?
Как только меняется факт, который влияет на ответы: цена, регламент, позиционирование. Устаревший документ опаснее пробела, потому что он уверенно врёт.
Может ли ИИ выдумать ответ, даже если факт есть в базе?
Может, если формулировка расплывчатая или в базе есть противоречие. Помогает прямой инструктаж отвечать только по источникам и регулярная проверка на контрольных вопросах.
Нужен ли программист, чтобы собрать базу знаний?
Для старта на готовых сервисах достаточно загрузить документы. Программист нужен, когда базу вшивают в продукт, бота или внутренний контур с разграничением доступов.
Сколько документов нужно для нормального старта?
Обычно хватает пяти-семи коротких файлов, которые закрывают самые частые вопросы. Дальше база растёт от реальных промахов, когда модель не смогла ответить.
Что делать с конфиденциальными данными?
Держать их отдельным набором с ограниченным доступом и не смешивать с базой, которая обслуживает публичные сценарии вроде чат-бота на сайте.