RAG простыми словами: как ИИ отвечает по твоим данным
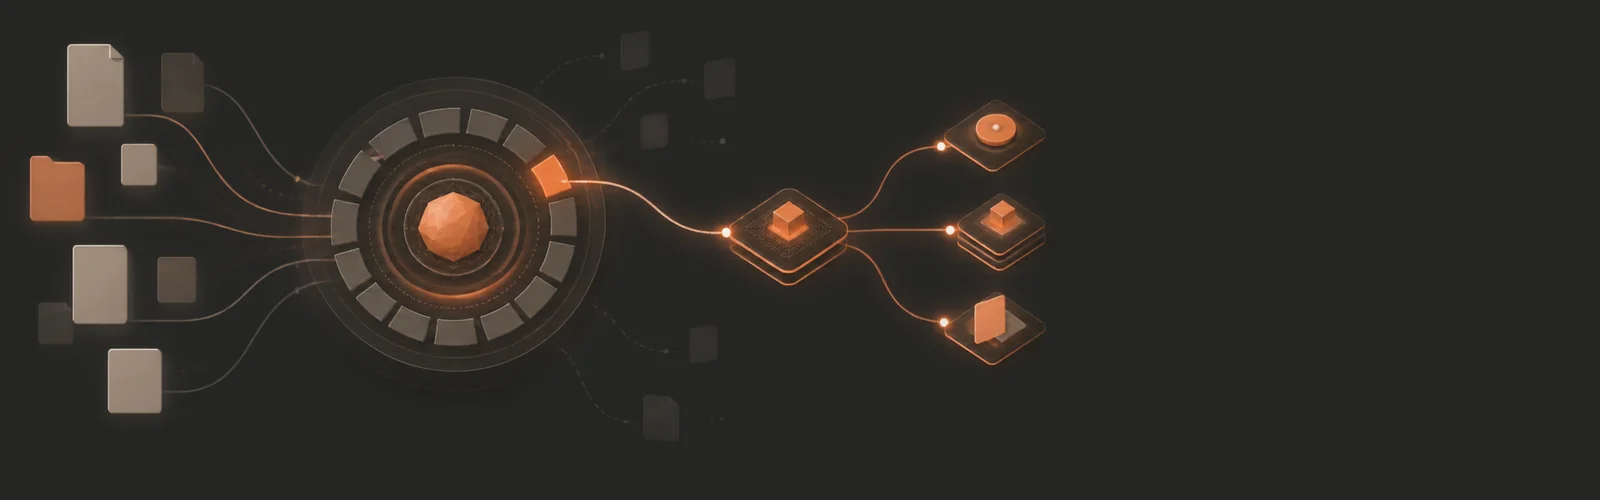
RAG - это способ заставить нейросеть отвечать по твоим документам. Схема из двух шагов: система находит в твоей базе подходящий кусок текста (регламент, прайс, кусок старой переписки), потом отдаёт этот кусок модели с инструкцией ответить строго по нему. Расшифровывается аббревиатура как Retrieval-Augmented Generation, «генерация с подкреплением поиском». Если совсем на пальцах: модель сначала подсматривает в твою шпаргалку и только после этого начинает формулировать.
Представь двух менеджеров на входящем звонке. Первый отвечает по памяти, звучит убедительно и держит темп разговора, пока клиент не выясняет, что названная цена была актуальна полгода назад. Второй тратит двадцать секунд, открывает карточку товара и называет то, что там написано сегодня. RAG превращает модель во второго менеджера.
Что происходит внутри RAG, если убрать термины?
Языковая модель работает как человек с очень широкой эрудицией и полным отсутствием доступа к твоим папкам. Она читала миллионы страниц публичных текстов, поэтому знает, как в принципе устроена гарантия на бытовую технику, как обычно формулируют условия возврата и какие бывают тарифы у транспортных компаний. Твоего прайса среди этих текстов не было никогда.
Когда ты спрашиваешь такую модель про свой бизнес, она достраивает ответ по общей логике жанра. Получается складно, грамотно и мимо. Именно этот эффект люди называют галлюцинациями, хотя механика тут скучнее: модель продолжает текст самым вероятным способом, а вероятность посчитана по всему интернету, куда твоя папка с документами никогда не попадала.
RAG вставляет между вопросом и ответом ещё одно звено - поиск. Прежде чем модель начнёт писать, система лезет в хранилище твоих текстов, вытаскивает оттуда два-три наиболее подходящих фрагмента и кладёт их в тот же запрос. Модель получает вопрос клиента и рядом с ним готовую выдержку из твоего регламента. Дальше ей остаётся сформулировать человеческий ответ по предоставленному материалу.
Отсюда следует главное практическое свойство RAG: качество упирается в то, что лежит в хранилище и насколько хорошо оно найдено. Умная модель поверх пустой базы даёт красивую выдумку. Средняя модель поверх аккуратной базы даёт рабочий ответ.
Зачем нужен RAG, если модель и так умная?
Эрудиция и знание твоего бизнеса живут в разных плоскостях. Модель разбирается в юридической логике возвратов вообще, но понятия не имеет, что вы вчера подняли цену на доставку по области и убрали бесплатный самовывоз из двух городов.
Ты можешь каждый раз копировать нужный документ в чат руками. Такой сценарий работает и называется ручным RAG, где роль поисковика исполняешь ты сам. Проблема появляется на масштабе: когда документов сорок, а вопросов в день сотня, копипаст съедает больше времени, чем экономит. Автоматический поиск снимает именно эту работу.
Второй мотив - контроль. Ответ, собранный из твоего текста, можно проверить: попросить систему показать, из какого фрагмента взята цифра, и сверить с оригиналом. Свободная генерация такой возможности не даёт, там проверять нечего.
Третий мотив - актуальность. Правишь документ в базе, и следующий же ответ учитывает правку. Никакого переобучения, никакого ожидания, никаких затрат на видеокарты.
Если ты только присматриваешься к ИИ для дела и пока не понял, с какого участка начинать, полезно сначала посмотреть обзорный разбор для малого бизнеса - там про выбор первой задачи, а RAG уже становится инструментом под неё.
Чем RAG отличается от обычного поиска по документам?
Поиск по папке возвращает список файлов, дальше человек открывает каждый и вычитывает нужное. RAG доводит работу до конца: находит фрагмент и формулирует по нему готовый ответ на языке вопроса. Разница ощущается на типовых обращениях, где клиенту нужна одна строчка из тридцатистраничного документа.
Второе отличие в том, как задаётся вопрос. Поиск по сайту требует угадать слово из документа. Векторный слой снимает это требование, поэтому запрос «диван привезли с царапиной, что делать» доводит клиента до пункта регламента про товар ненадлежащего качества, где слова «царапина» нет вовсе.
Третье отличие - сборка ответа из нескольких мест сразу. Условие доставки лежит в одном файле, стоимость подъёма на этаж во втором, срок сборки в третьем. Система достаёт три фрагмента разом и складывает из них одну реплику, чего обычный поиск по документам по своей природе не делает.
Ограничение тоже стоит держать в голове. RAG отвечает по тому, что нашёл, и не умеет считать по всей базе целиком. Вопрос «сколько у нас позиций дороже ста тысяч» решается запросом к таблице или выгрузкой в базу данных, поиск фрагментов тут бессилен. Карту того, какие процессы вообще имеет смысл отдавать машине, мы разбирали в обзоре автоматизации бизнес-процессов с ИИ.
Что дешевле бизнесу - дообучение или RAG?
Дать модели твои знания можно двумя дорогами, и путать их дорого.
Дообучение (fine-tuning) меняет саму модель. Ты собираешь датасет из своих текстов, гоняешь обучение, получаешь версию, в весах которой растворились твои данные. Дорого по деньгам, долго по времени, требует человека с профильными руками. Главная засада впереди: изменил прайс - и вся процедура повторяется заново, потому что выковырять один факт из весов нельзя.
RAG оставляет модель нетронутой и работает с внешним хранилищем. Обновление сводится к замене файла. Стоимость входа измеряется часами, а не неделями, и первую версию реально собрать без разработчика.
| Критерий | Дообучение | RAG |
|---|---|---|
| Обновление данных | Полный цикл переобучения | Заменил документ в базе |
| Порог входа | Нужен специалист по ML | Хватает конструктора ассистентов |
| Проверяемость ответа | Источник не показать | Модель ссылается на фрагмент |
| Что даёт лучше всего | Стиль, формат, тон, узкий навык | Факты, цифры, регламенты |
| Скорость первой версии | Недели | Часы или дни |
Разумное разделение выглядит так: фактура живёт в RAG, манера общения задаётся промптом, а дообучение остаётся для случаев, где нужен нестандартный формат вывода или очень узкая доменная задача. Малому бизнесу вторая дорога обычно не нужна вовсе.
Про манеру ответа стоит сказать отдельно. Тон, длина реплики, запрет обещать скидки от себя - всё это задаётся инструкцией и переписывается за минуту, тратить на такие вещи обучение бессмысленно. Второй фактор выбора после качества базы - способность конкретной модели удерживать длинный контекст и не отступать от инструкции; по этому признаку семейства заметно расходятся, и разбор одного из них лежит в материале про Claude.
Как это работает по шагам?
Полный путь от файла до ответа состоит из пяти этапов. Математику внутри знать необязательно, а вот этапы стоит держать в голове: каждый из них ломается по-своему.
- Нарезка (chunking). Документы режутся на фрагменты по несколько абзацев. Регламент на двадцать страниц превращается в полсотни кусков. Размер фрагмента определяет, что вообще сможет найтись.
- Векторизация (embeddings). Каждый кусок прогоняют через отдельную модель, которая превращает текст в длинный набор чисел - «отпечаток смысла». Тексты о похожем получают похожие числа даже при разных словах.
- Хранение. Отпечатки складывают в векторную базу - хранилище, которое умеет быстро находить ближайшие по смыслу записи среди сотен тысяч.
- Поиск (retrieval). Приходит вопрос. Его тоже превращают в отпечаток и достают из базы три-пять ближайших фрагментов.
- Генерация (generation). Найденные фрагменты вместе с вопросом уходят модели с инструкцией отвечать по предоставленному тексту. На выходе получается человеческая формулировка.
Ключевая мысль: судьба ответа решается на четвёртом шаге. Модель может быть сколь угодно сильной, но с неправильным фрагментом на входе она выдаст уверенный и неверный текст. Поэтому основная работа при внедрении RAG приходится на подготовку и нарезку документов, а выбор модели идёт следом.
Логика тут та же, что при сборке любого автоматизированного процесса: сначала наводишь порядок в данных, потом накрываешь их инструментом. Про этот порядок действий подробно писали в разборе, с каких задач начинать автоматизацию рутины.
Почему смысл чаще всего теряется на нарезке?
Chunking выглядит технической мелочью ровно до первого провального ответа. Разберём, как размер фрагмента влияет на результат.
Крупные куски по две-три страницы тянут за собой лишний контекст. Модель получает вопрос про сроки доставки и вместе с ним абзацы про упаковку, про акции и про порядок оформления счёта. Ответ размывается, растёт расход токенов, а иногда модель цепляется за соседний абзац и отвечает не на тот вопрос.
Мелкие куски по паре предложений теряют связь с контекстом. Фрагмент «в этом случае срок составляет четырнадцать дней» без указания, о каком случае речь, бесполезен для поиска и опасен для ответа.
Рабочий ориентир для бизнес-документов - фрагмент размером с логически завершённый раздел: один пункт регламента, одна карточка товара, один вопрос из FAQ вместе с ответом. Помогают несколько приёмов:
- Резать по структуре документа. Заголовок раздела и его текст должны попасть в один фрагмент, деление по числу символов такой гарантии не даёт.
- Дублировать заголовок внутрь куска. Строчка «Раздел 4. Возврат товара надлежащего качества» в начале фрагмента резко повышает шансы, что поиск найдёт его по слову «возврат».
- Делать перехлёст. Соседние фрагменты частично перекрываются, и мысль, разорванная границей, всё равно целиком попадает хотя бы в один кусок.
- Разносить разные темы по разным файлам. Свалка «Всё про компанию.docx» на восемьдесят страниц режется хуже, чем десяток тематических документов.
Эти правила окупаются быстрее любых настроек модели: правильно нарезанный документ находится с первого раза, а криво нарезанный приходится вылавливать переформулировками запроса.
Почему векторный поиск понимает синонимы?
Обычный текстовый поиск ищет совпадение слов. Клиент пишет «хочу сдать обратно диван», в регламенте написано «возврат товара надлежащего качества», общих слов ноль, поиск возвращает пустоту.
Векторный поиск работает иначе. Модель-эмбеддер переводит каждый текст в точку в пространстве с сотнями измерений. Расположение точки определяется смыслом: фразы про возврат покупки собираются в одном районе этого пространства, фразы про доставку в другом. Поиск сводится к геометрии: берём точку вопроса и смотрим, какие точки документов оказались рядом.
Отсюда способность находить по смыслу. «Сдать обратно», «вернуть», «оформить возврат», «не подошёл цвет» окажутся соседями, хотя буквенного пересечения между ними почти нет.
У подхода есть слабое место. Смысловая близость иногда подводит на терминах и артикулах: «модель 3021» и «модель 3120» для эмбеддера почти одно и то же, а для клиента это два разных дивана. Поэтому серьёзные сборки комбинируют два поиска, векторный по смыслу и классический по ключевым словам, а результаты объединяют. Такая схема называется гибридным поиском и заметно поднимает точность на каталогах и прайсах.
Практический вывод для владельца бизнеса: если ассистент путает похожие артикулы, дело не в модели, лечится это настройкой поиска.
Что класть в базу знаний бизнеса?
RAG - это движок, а база знаний - топливо. Собранная с головой база превращает обычный конструктор в толкового консультанта. Свалка из PDF, скриншотов и трёх версий прайса даёт красивый механизм, который выдаёт мусор с уверенным лицом.
Раскладывать знание стоит так, как его искал бы живой человек. Вот что реально работает:
| Тип документа | Что закрывает | Где ломается |
|---|---|---|
| Прайс и условия | Вопросы про цену, сроки, доставку | Устаревшая версия - модель называет старую цену |
| Регламенты (возврат, гарантия) | Типовые обращения поддержки | Размытые формулировки «на усмотрение менеджера» |
| FAQ и переписки | Реальные вопросы клиентов их словами | Дубли и противоречивые ответы из разных лет |
| Описание продуктов | Консультация до покупки | Маркетинговая вода вместо конкретики |
| Внутренние инструкции | Онбординг, ответы команде | Персональные данные, которым там не место |
Отдельного внимания заслуживают переписки с клиентами. В них лежит золото, а именно формулировки, которыми люди реально задают вопросы. Выгрузка из чатов поддержки, причёсанная до формата «вопрос - ответ», часто даёт больше пользы, чем идеально написанный регламент, потому что совпадает с языком клиента.
Второй источник пользы - список того, чего в базе быть не должно. Черновики, отменённые акции, прошлогодние условия, три варианта одного документа с именами «финал», «финал2» и «финал_итог». Каждый такой файл однажды всплывёт в ответе клиенту.
Развёрнутый разбор того, как собрать и структурировать эту базу с нуля, лежит в материале про базу знаний для нейросети - там про форматы, порядок наполнения и типовые ошибки на старте.
Как это выглядит на примере магазина мебели?
Возьмём воображаемый салон мебели с прайсом на полторы сотни позиций, регламентом возврата, условиями доставки по трём тарифным зонам и парой лет переписки в мессенджере. Задача - снять с менеджера повторяющиеся вопросы.
Первая сборка выглядит наивно: закинули все файлы в конструктор ассистентов, задали вопрос «можно ли вернуть диван, если не подошёл цвет», получили ответ про четырнадцать дней со ссылкой на закон. Формально придраться не к чему, только клиенту салона от такого ответа ни холодно ни жарко: в регламенте для мебели на заказ прописано отдельное условие, и поиск его не достал.
Разбираем причину. Регламент лежал одним файлом на тридцать страниц, нарезка разрубила пункт про мебель на заказ пополам, а заголовок раздела остался в соседнем фрагменте. Поиск нашёл общий кусок про сроки, потому что тот выглядел смыслово ближе.
Что помогло:
- Регламент разбили на отдельные документы по темам: серийная мебель, мебель на заказ, доставка, сборка, гарантия.
- В начало каждого фрагмента добавили строку с названием раздела и категорией товара.
- Из переписки собрали два десятка реальных вопросов с ответами и положили отдельным файлом.
- В инструкцию модели добавили правило: при вопросе про возврат сначала уточнить, серийная позиция или заказная.
- Прайс перевели из PDF в таблицу, где каждая строка стала отдельной записью с артикулом, названием и ценой.
Отдельно пришлось решать вопрос с ценами. Прайс в салоне меняется чаще регламента, и хранение его как обычного текста означает ловить устаревшие цифры каждый месяц. Позиции вынесли в один файл с датой в названии и завели правило: обновляется в тот же день, что и цены на сайте. Индивидуальные заказы вывели из базы целиком, на такие вопросы ассистент теперь предлагает связать клиента с менеджером.
После этих правок тот же вопрос стал получать ответ с правильным условием и ссылкой на нужный пункт. Обрати внимание на состав работ: модель не меняли ни разу, весь результат дала подготовка данных.
Третий этап - подключить готового ассистента к каналу, где сидят клиенты. Механика этого шага разобрана в статье про чат-бота для бизнеса, а связка нескольких таких помощников в один процесс - в разборе ИИ-агентов.
Какие данные нельзя пускать в базу?
Персональные данные клиентов, паспортные сведения, внутренние финансовые документы, договоры с поставщиками - всё это попадает в базу по одной причине: кто-то загрузил папку целиком, не глядя. Дальше срабатывает механика RAG: поиск сочтёт фрагмент релевантным, модель добросовестно процитирует его клиенту в чате.
Минимальная гигиена выглядит так:
- Разделять контуры. База для клиентского бота и база для внутреннего помощника - разные хранилища с разным содержимым.
- Чистить выгрузки. Переписку перед загрузкой стоит обезличить: убрать имена, телефоны, адреса, номера заказов.
- Проверять права доступа. Если помощником пользуется вся команда, в базе не должно лежать то, что видит только руководитель.
- Держать реестр. Простой список файлов с датой обновления и ответственным избавляет от вопроса «откуда он вообще это взял».
Продумывать это удобнее до запуска. Разбирать последствия утечки в чате с клиентом - занятие дорогое и нервное.
Где RAG ломается и как это проверить?
Отказы концентрируются в нескольких точках: промах поиска, дыра в базе, противоречие между документами и устаревший файл. Проверять систему нужно по одному критерию - откуда взялся ответ.
Поиск нашёл не то. Вопрос про возврат, а система подтянула фрагмент про гарантию. Формулировка выходит гладкой и мимо темы. Лечится нарезкой поменьше, заголовками внутри фрагментов и добавлением гибридного поиска.
В базе ответа нет, а модель не признаётся. Вместо честного «в документах этого не нашлось» она выдаёт правдоподобную выдумку. Лечится жёсткой инструкцией в промпте: при отсутствии информации во фрагментах модель обязана сказать об этом и предложить переключить на человека.
Два документа спорят друг с другом. Старая версия регламента обещает десять дней, новая четырнадцать, обе лежат в хранилище. Поиск подтянет ту, что окажется ближе по формулировке, и ответ превращается в лотерею. Лечится ревизией: на один вопрос в базе остаётся один действующий документ, предыдущие версии уезжают в архив за пределы хранилища.
Документ устарел. Подняли цену, старый прайс остался в базе, поиск честно нашёл старый. Лечится регламентом обновления с ответственным человеком и датой.
Как проверить систему за полчаса: собери двадцать вопросов, ответы на которые знаешь точно, прогони их через ассистента и по каждому попроси показать фрагмент-источник. Дальше считай три числа - сколько ответов верные, сколько ответов неверные и сколько раз система честно призналась в незнании. Третья категория при запуске должна быть заметной; ассистент, который отвечает на всё подряд, врёт чаще, чем кажется.
Такой прогон по контрольному списку - обычная практика при работе с любой аналитикой на ИИ. Про формулировки проверочных вопросов есть отдельный материал: какие вопросы задавать ИИ-аналитику.
Честная граница возможностей тоже стоит проговаривания. RAG найдёт регламент и сформулирует по нему ответ, а решение по нестандартному спору с клиентом, выбор тона в конфликте и ответственность за последствия остаются на человеке.
Что отвечать на частые возражения?
«У меня всего двадцать документов, это перебор». Двадцать документов - уже нормальный старт, потому что боль измеряется не объёмом базы, а числом повторяющихся вопросов. Если менеджер десять раз в день лезет в один и тот же файл за одной и той же строчкой, автоматический поиск окупается на первой неделе.
«Проще научить сотрудника». Обучение сотрудника решает задачу до его отпуска, увольнения и прихода следующего новичка. База знаний под RAG при этом окупается дважды: она работает и как топливо для помощника, и как материал для онбординга живых людей. Расчёт того, где ИИ обходится дороже человека, лежит в отдельном честном разборе.
«Модель всё равно будет врать». Врать она будет реже ровно в той мере, в какой ты вложишься в базу и в проверку источников. Система с обязательной ссылкой на фрагмент даёт возможность поймать ошибку до того, как её увидит клиент.
«Наши документы слишком сложные». Сложность документов бьёт по нарезке, а идея целиком от этого не рушится. Сложный регламент разбивается на тематические файлы, каждый из которых уже читается по одному вопросу. Работа кропотливая, зато делается один раз.
«Клиент спросит то, чего в базе нет». Такие вопросы будут всегда, и правильный сценарий для них прописывается заранее: ассистент говорит, что не нашёл информацию, и передаёт диалог человеку. Список подобных обращений стоит копить отдельно, он и станет планом дописывания базы на следующий месяц.
«Это дорого». Стартовый вариант на готовом конструкторе стоит подписки и нескольких вечеров твоего времени. Дорогая часть начинается на своей сборке с векторной базой, гибридным поиском и интеграциями, туда стоит идти после того, как простая версия доказала пользу.
Отдельная развилка - какие задачи вообще отдавать помощнику первым делом. Тут пригодится список из семи задач для ассистента в малом бизнесе и более общий перечень задач, которые ассистент закрывает.
Собрать самому или взять готовое?
Выбор упирается в объём и требования к данным.
Готовые конструкторы ассистентов принимают файлы, сами делают нарезку и векторизацию, отдают виджет или бота. Десяток документов, типовые вопросы, отсутствие жёстких требований к хранению - этого сценария хватает большинству малых компаний. Плюсы очевидны: запуск за вечер, никакого кода, предсказуемая цена подписки. Минусы всплывают позже: настройки нарезки скрыты, гибридного поиска обычно нет, данные лежат на чужой стороне.
Своя сборка нужна при других вводных: база на тысячи документов, требование хранить данные внутри контура, необходимость тонко управлять поиском, интеграция с CRM и складом. Здесь появляются векторная база, свой пайплайн загрузки документов и человек, который всё это обслуживает. Промежуточный вариант - собрать процесс на низкокодовой платформе вроде n8n, где узлы для векторных баз и моделей уже готовы; про освоение такого инструмента есть пошаговый разбор n8n с нуля.
Логика выбора здесь совпадает с той, что работает при внедрении агентов: сначала проверить гипотезу дешёвым способом, потом вкладываться в свою инфраструктуру. Развёрнуто эта развилка описана в статье про агентов под ключ или сборку самому.
С чего начать на этой неделе?
Порядок действий для первой рабочей версии выглядит так:
- Выпиши двадцать самых частых вопросов. Возьми их из переписки поддержки, а не из головы.
- Собери документы, где лежат ответы. На этом шаге обычно выясняется, что на треть вопросов письменного ответа не существует вовсе.
- Допиши недостающее. Короткие ответы в формате «вопрос - ответ» пишутся быстрее регламентов и находятся поиском лучше.
- Причеши форматы. PDF со сканами замени текстом, таблицы вынеси в отдельные файлы, длинные документы разбей по темам.
- Загрузи в конструктор и прогони контрольные вопросы. Двадцать штук из первого пункта.
- Почини то, что не нашлось. Обычно правится нарезкой и заголовками, редко сменой инструмента.
- Назначь ответственного за обновление. База без хозяина устаревает за месяц.
Первые шесть пунктов реально закрыть за несколько вечеров. Дальше начинается сборка полноценного помощника с ролью, тоном и сценариями - этот путь разложен в инструкции по сборке ИИ-сотрудника за пять шагов, а сам концепт такого помощника разобран в материале что такое цифровой сотрудник.
Если хочется пройти этот путь в структурированном виде, начни с бесплатного курса в личном кабинете ИИмперии: забрать бесплатное обучение - там пошагово про базу знаний, промпты и запуск первого помощника без кода.
Разбор реальных связок RAG, готовые инструкции для моделей и шаблоны ролей выкладываем в закрытый канал ИИмперии - в рабочем виде, с примерами настроек.
Источники
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020) - оригинальная научная статья, где впервые описан подход RAG.
- Anthropic: Introducing Contextual Retrieval - разбор приёмов, повышающих точность поиска в RAG-системах.
- OpenAI: Embeddings guide - официальная документация по векторизации текста, второй шаг механики.
- Pinecone: Retrieval-Augmented Generation - практическое объяснение RAG от разработчиков векторной базы.
Частые вопросы
Чем RAG отличается от обычного промпта с приложенным текстом?
При обычном промпте ты вручную вставляешь нужный кусок в чат. RAG делает этот поиск сам: из тысяч документов достаёт релевантные и подкладывает их модели без твоего участия.
Нужно ли дообучать модель, чтобы она знала мои данные?
Дообучение для этого не требуется. При RAG данные лежат отдельно в базе, а модель обращается к ним в момент ответа. Обновил документ - ответы сразу учитывают правку.
RAG полностью убирает галлюцинации?
Он их снижает. Если в базе есть точный ответ и поиск его нашёл, модель отвечает по факту. При дырах в базе или промахе поиска она всё равно способна додумать.
Сколько документов нужно, чтобы RAG имел смысл?
Даже десяток регламентов и прайс уже дают эффект. Смысл появляется там, где ты устал копипастить одно и то же в чат вручную.
Можно собрать RAG без программиста?
Простой вариант - да, на готовых конструкторах ассистентов, куда загружаешь файлы. Тонкую настройку под большие базы обычно уже делают руками разработчика.