Второй мозг для бизнеса: что это и зачем
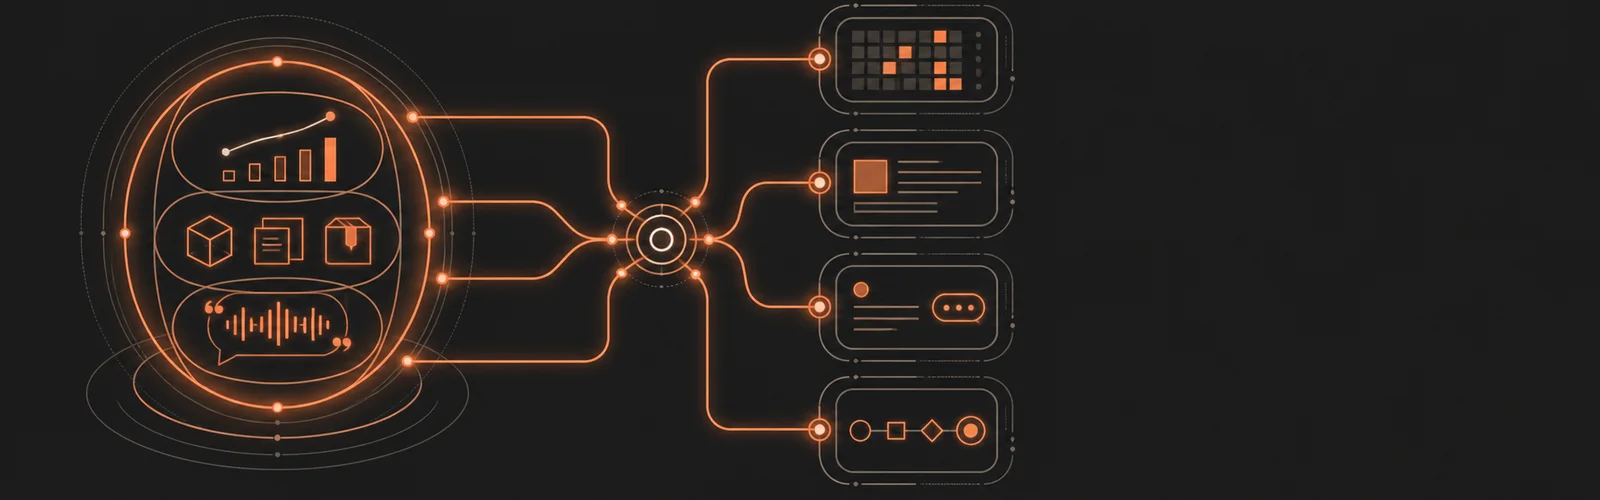
Второй мозг бизнеса - внешняя память, куда сложены проверяемые факты о деле: экономика и цены, описание продуктов и клиентов, правила языка, принятые решения и запреты. Модель заглядывает в эту память перед тем, как взяться за задачу, и строит ответ на твоих данных. Без памяти на их место встаёт усреднённая картинка из обучающей выборки.
Я понял, зачем это нужно, когда собирал ИИ-команду под свои задачи. Модель может быть сколь угодно сильной и всё равно приходит на каждую задачу новичком в первый рабочий день: без моих цифр, без вчерашних договорённостей, с языком, усреднённым по всему интернету. Общий способ решения задачи она знает прекрасно, а подробности конкретного дела ей взять неоткуда.
Сама идея старше любых нейросетей. Тиаго Форте называл вторым мозгом внешнее хранилище знаний: складываешь туда то, что не хочешь держать в голове, и освобождаешь голову под мышление. Я перенёс принцип на команду из моделей, поменяв читателя: раньше в хранилище лазил человек, теперь туда лазит ИИ перед каждым запуском.
Почему модель каждый раз начинает с чистого листа?
У языковой модели нет состояния между сессиями. Всё, что она знает о тебе прямо сейчас, лежит в контексте текущего диалога и исчезает вместе с закрытым чатом. Завтра ты открываешь новое окно и заново объясняешь, кто твой клиент, сколько стоит подписка и почему в текстах запрещена формулировка «лучшее решение на рынке».
Дальше включается механика поинтереснее. Когда нужного факта нет, модель редко останавливается с вопросом: пробел достраивается статистически правдоподобным вариантом. Спросишь про юнит-экономику без своих цифр - получишь среднюю по рынку, собранную из тысяч чужих статей. Выглядит гладко и читается уверенно, а к твоему делу отношения не имеет. Отсюда растёт добрая половина претензий про галлюцинации: модели нечем заполнить дыру, и она заполняет её правдоподобным шумом.
Третья деталь всплывает позже, когда контекст разрастается. Даже если вывалить все вводные в один огромный промпт, читается он неравномерно: середина длинного текста теряется заметно чаще, чем начало и конец. Исследователи описали этот эффект под названием lost in the middle, и практический вывод получается простым - память держим короткой, разложенной по темам, а самое важное выносим в начало и конец файла.
Пока памяти не было, мой рабочий цикл выглядел так: открыть чат, вручную пересказать вводные, получить красивый чужой текст, потратить полдня на правку до узнаваемого состояния. Экономия времени в такой схеме отрицательная, и ощущение «быстрее сделать самому» тут абсолютно честное.
Чем второй мозг отличается от заметок и вики компании?
Разница спрятана в адресате. Заметки и вики пишут для человека, а человек достраивает пропущенное сам: он знает, что «база» в третьем абзаце означает базовый тариф, помнит, что цена в файле полугодовой давности с тех пор выросла, и понимает, что раздел про партнёрку писали для юристов. У модели этого запаса нет.
Поэтому память для ИИ пишут по другим правилам:
- Каждый факт сформулирован явно. Сокращения расшифрованы при первом появлении, у каждой цифры стоит дата и единица измерения, у каждого правила есть пример правильного и неправильного применения.
- Одна тема - один короткий файл. Разбитая память ищется лучше, чем монолит на сорок страниц, и обновляется без страха задеть соседнее.
- Противоречия вычищены. Человек между двумя версиями цены выберет свежую, модель выберет случайную.
- Написано языком дела, без корпоративного тумана. Фраза вроде «решение для роста бизнеса» не несёт ни одного факта, который модель могла бы использовать.
Отдельный разбор того, как готовить материалы под чтение моделью и какие форматы она усваивает лучше, лежит в статье про базу знаний для нейросети. Вики компании и второй мозг спокойно уживаются рядом: первое остаётся справочником для людей, второе становится выжимкой из него, переписанной под машинное чтение.
С каких трёх блоков начинать?
Описывать бизнес целиком бессмысленно, эту работу бросают на третий день. Рабочий минимум состоит из трёх блоков, которые закрывают большинство ежедневных задач.
Цифры
Здесь живут проверяемые факты: средний чек, себестоимость, маржинальность по направлениям, структура цены, стоимость привлечения клиента, ключевые метрики за последний закрытый период, сезонность.
Пока этого блока нет, аналитик и продавец считают по усреднённой рыночной экономике, то есть фантазируют с умным видом. Красивые числа выдумывать бессмысленно, память имеет смысл только на настоящих данных. Там, где данных нет, я пишу прямо: «CAC не считался, оценки нет». Модель с таким текстом ведёт себя честнее и сообщает, что для расчёта не хватает вводных, вместо того чтобы подставить придуманное значение. Какие вопросы после этого стоит задавать своим же данным, я разбирал в материале про ИИ для бизнес-аналитики.
Продукты и аудитория
Что продаёшь, кому, какую боль закрываешь, чем отличаешься от соседей по рынку, какие возражения слышишь чаще всего и что на них отвечаешь. Это топливо для маркетолога, продавца и копирайтера, без него текст получается адресованным всем сразу и потому никому.
Продукт описывай по-человечески: что человек получает, за что платит, что входит в цену, что не входит. Рядом положи портрет клиента с его собственными словами - теми, которыми он сам называет свою проблему в переписке и на созвонах. Формулировки клиента дороже любых маркетинговых определений: модель начинает говорить на языке аудитории, потому что взяла его из первоисточника. Какие задачи в этом блоке отдают ИИ первыми, полезно посмотреть в разборе задач для ИИ-ассистента и в подборке семи задач для малого бизнеса.
Тон голоса
Как ты говоришь и чего не говоришь никогда. Три-пять собственных удачных текстов целиком, список стоп-слов, запрещённые приёмы, технические правила: длина абзацев, обращение на «ты» или на «вы», допустимость шуток, отношение к восклицательным знакам и эмодзи.
Один раз записанные правила превращают любого цифрового сотрудника в узнаваемый голос вместо безликой нейросети. Примеры работают сильнее описаний: два своих абзаца с пометкой «так пишу» дают модели больше, чем страница рассуждений о ценностях бренда. Насколько далеко эта узнаваемость заходит и где начинается самообман, я разбирал в тексте про цифрового двойника сотрудника.
| Блок | Что кладём | Кому в команде нужен |
|---|---|---|
| Цифры | чек, маржа, метрики, структура цены | аналитик, продавец |
| Продукты и аудитория | что продаём, кому, боль, отличия, возражения | маркетолог, продавец, копирайтер |
| Тон голоса | примеры текстов, стоп-слова, правила | копирайтер, дизайнер, поддержка |
Какой блок появляется сам собой?
Через пару недель работы у меня завёлся файл, которого не было в плане: решения и запреты. Туда попадает всё, что уже обсуждалось и закрыто.
Выглядит он как список коротких строк с датами: отказались от рассрочки, потому что она ломает экономику; не берём клиентов без бюджета на внедрение; в текстах не используем слово «топовый»; на вопрос про гарантии отвечаем вот такой формулировкой. Каждая строка снимает один повторяющийся спор.
Ценность этого блока становится видна не сразу. Первые дни он выглядит свалкой мелочей, а через месяц выясняется, что именно он избавляет от возвращения к решённым вопросам. Модель перестаёт предлагать варианты, которые ты уже отверг по причинам, известным только тебе, и заодно перестаёт спорить с самой собой между сессиями.
Как собрать первую версию за один вечер?
Первая версия второго мозга собирается без кода, без программиста и без специальных сервисов: нужна папка с текстовыми файлами и свободный вечер. Порядок работы такой.
- Заведи папку и три файла:
цифры.md,продукты.md,тон.md. Формат markdown удобен заголовками и списками, но обычный txt тоже сработает. - Заполни их фактами. Пиши так, будто вводишь в курс дела нового сотрудника в первый день: коротко, конкретно, без парадных формулировок про многолетний опыт. Ориентир по объёму - одна-две страницы на файл, дальше начинается вода.
- Проверь на живой задаче. Дай модели прямое поручение: «Вот мои цифры, продукты и правила языка. Напиши пост про [тему], опираясь только на эти данные. Если каких-то фактов не хватает, перечисли их и не придумывай».
- Отследи, где модель споткнулась. Каждый выдуманный факт и каждый уточняющий вопрос указывает на конкретную дыру в памяти. Дописал - дыра закрылась. Память растёт от реальных пробелов, обнаруженных на задачах.
- Повтори на трёх-четырёх разных задачах. После этого второй мозг начинает закрывать большинство вопросов самостоятельно.
Один приём экономит мне часы. Перед тем как модель возьмётся за работу, прошу её пересказать своими словами, что она поняла из моих файлов. Пересказ мгновенно вскрывает неполные места и внутренние противоречия: там, где память дырявая, пересказ становится обтекаемым, а где факты спорят между собой, модель выбирает один и тем самым показывает конфликт. Если хочется собрать под задачу полноценную роль с инструкцией и границами, есть отдельная пошаговая инструкция, как собрать ИИ-сотрудника с нуля.
Как выглядит файл цифр изнутри?
Абстрактные советы работают плохо, поэтому вот структура, к которой я пришёл после нескольких переписываний. Значения в примере условные и приведены ради формы записи.
# Цифры (обновлено 12.08.2026)

## Экономика подписки
- Цена базового тарифа: 2 900 ₽/мес, оплата разовая или помесячно
- Себестоимость обслуживания одного клиента: 400 ₽/мес (инфраструктура + поддержка)
- Средний срок жизни клиента: данных пока нет, считаем с сентября

## Каналы
- Основной источник заявок: телеграм-канал
- Стоимость привлечения: не считалась, оценки в память не класть

## Пометки
- Цена базового тарифа: БРАТЬ СВЕЖИМ, меняется чаще раза в квартал
Всю работу здесь делают три вещи. По дате обновления в заголовке модель понимает, насколько данные свежие, и в спорном месте сама предупреждает, что информация могла устареть. Явные признания «данных пока нет» закрывают дорогу к достраиванию пробела выдумкой, потому что отсутствие факта становится таким же фактом. Пометка «брать свежим» выделяет поля, которые протухают быстрее остальных, и в промпте я на неё прямо ссылаюсь: «если поле помечено как брать свежим, спроси у меня актуальное значение перед расчётом».
Файлы продуктов и тона устроены так же: заголовок с датой, короткие блоки, явные пометки о неизвестном. Единственное отличие в том, что в файле тона половину объёма занимают живые примеры текстов, а не правила о них.
Как подключить память к модели?
Способы отличаются трудозатратами и степенью автоматизации. Переходить к следующему имеет смысл, когда предыдущий начал жать.
Копирование в чат. Самый простой вариант: в начале диалога вставляешь содержимое нужных файлов и дальше работаешь. Годится для проверки идеи и первых задач, утомляет уже на второй неделе.
Постоянный контекст на стороне сервиса. Проекты и пользовательские инструкции есть почти во всех крупных чат-интерфейсах: файлы загружаются один раз и подхватываются в каждом новом диалоге внутри проекта. Здесь же настраиваются постоянные правила поведения. Для одиночной работы этого хватает надолго, особенно если разложить файлы по темам. Что умеют конкретные модели и чем отличается их работа с длинным контекстом, я разбирал на примере Claude.
Автоматическая подгрузка. Когда цифры живут в CRM или таблицах, руками их переносить бессмысленно. Сценарий в но-код автоматизаторе раз в сутки собирает свежие значения, обновляет файл памяти и передаёт его агенту вместе с задачей. Порог входа тут выше, зато память перестаёт зависеть от твоей дисциплины. Путь к этому уровню описан в руководстве, как освоить n8n с нуля.
Между вторым и третьим уровнем есть промежуточная ступень: держать память в облачном документе и давать агенту ссылку на него. Обновление остаётся ручным, зато правки становятся мгновенными и доступными с телефона, а это решает проблему «поменял цену в дороге, забыл к вечеру».
Что меняется в обычной задаче после подключения памяти?
Возьмём типовую просьбу, которая повторяется у любого владельца бизнеса: написать пост о новом тарифе.
Без памяти диалог развивается предсказуемо. Модель выдаёт текст с обещаниями вроде «доступная цена» и «выгодные условия», потому что настоящей цены она не знает. Тон получается нейтрально-рекламным, аудитория описана как «предприниматели и специалисты», выгоды перечислены общими словами. Дальше начинается ручная работа: подставить цену, вырезать канцелярит, переписать заход, добавить конкретику, разбить абзацы. Правка занимает больше времени, чем написание с нуля, и это ровно тот опыт, после которого люди объявляют нейросети бесполезными.
С памятью тот же запрос обрабатывается иначе. Модель берёт из файла цифр точную стоимость и структуру тарифа, из файла продуктов - формулировку боли теми словами, которыми её называют клиенты, из файла тона - длину абзацев и запрет на слово «выгодный». Текст приходит с настоящими числами, узнаваемым голосом и конкретными выгодами. Правки никуда не деваются, но меняется их характер: вместо переписывания заново ты трогаешь два-три места, где хотел другой акцент.
Побочный эффект оказался ценнее основного. Модель начинает задавать осмысленные вопросы: «в памяти цена базового тарифа помечена как быстро устаревающая, подтверди значение» - это ровно то поведение, ради которого пометки и заводились. Вместо уверенного вранья получаешь запрос на уточнение в единственном месте, где он действительно нужен.
Чего память не чинит, тоже стоит назвать. Слабая идея поста останется слабой, просто изложат её твоим голосом и с твоими цифрами. Структура текста, угол подачи и решение о публикации по-прежнему держатся на человеке, и второй мозг тут помогает разве что косвенно - освобождает голову от механики.
Где второй мозг ломается и как это заметить?
Проверка занимает пять минут. Дай двум разным задачам подряд один и тот же контекст и посмотри, удерживает ли модель тон и цифры без напоминаний. Устойчивый результат означает, что память работает; постоянные переспрашивания указывают на дыры.
Ломается она в трёх местах:
- Устаревание. Цена в жизни поменялась, в файле лежит прежняя. Лечится привычкой: правишь в реальности - правишь в памяти в тот же день. Быстро меняющиеся поля помечай как «брать свежим», тогда модель сама попросит подтверждение.
- Свалка вместо структуры. Всё ссыпано в один гигантский файл, нужный факт тонет в середине. Режь по темам, держи файлы короткими, выноси важное в начало и конец.
- Противоречия. В одном месте чек 3 000, в другом 5 000, модель выбирает наугад и уверенно обосновывает выбор. Раз в две недели я прошу её саму пройтись по памяти и выписать факты, которые спорят друг с другом. Находит она их лучше меня, потому что читает без предвзятости и не помнит, какая версия считалась правильной.
Четвёртая поломка встречается реже и бьёт больнее: память, написанная под одну задачу, начинает мешать другим. Файл тона, заточенный под телеграм-посты, портит коммерческие предложения короткими рублеными фразами там, где нужен развёрнутый аргумент. Лечение простое - развести правила по каналам и подключать нужный набор под конкретную работу.
Сколько времени память отнимает каждую неделю?
Сборка первой версии заняла у меня вечер, дальше расходы падают до нескольких минут. Живой слой правится в момент изменения: поменял цену - открыл файл, заменил число, поставил дату. Полминуты работы, если делать сразу, и полчаса раскопок, если копить правки неделями.
Раз в две недели полезен короткий прогон на противоречия: просишь модель прочитать память и выписать всё, что спорит друг с другом, устарело по дате или сформулировано так, что допускает два толкования. Список приходит за минуту, правки занимают ещё пять.
Дороже всего обходится первое заполнение, причём не из-за объёма текста. Там приходится честно смотреть на цифры, которых нет: у многих на этом шаге выясняется, что стоимость привлечения клиента никто не считал, а маржа по направлениям существует исключительно в ощущениях. Память вскрывает такие пробелы раньше, чем они превращаются в неверное решение, и эта польза с нейросетями вообще не связана.
«У меня всё меняется каждый месяц, зачем это описывать?»
Возражение честное, и ответ на него лежит в структуре памяти. Меняется в бизнесе гораздо меньше, чем кажется изнутри: конкретные цены, текущие акции, состав команды, приоритеты квартала. Позиционирование, портрет клиента, суть продукта и манера речи живут месяцами и годами.
Поэтому я держу два слоя. Стабильный пишется один раз и переживает несколько итераций бизнеса почти без правок. Живой помечен как быстро устаревающий и обновляется по факту изменения, без отдельного подвига раз в квартал. Уходят на это минуты в неделю, и пару раз именно они избавили меня от переписывания готового материала с настоящими на вид, но давно неверными числами.
Если бизнес молодой и всё в нём действительно плавает, начни только со стабильного слоя. Тон голоса и описание клиента фиксируются даже тогда, когда цена меняется каждую неделю, а цифры подтянутся, когда устаканятся.
«Это же обычный промпт, зачем городить файлы?»
Разница вылезает на второй неделе. Промпт живёт в голове и в истории одного чата, его невозможно передать другому агенту, версионировать или проверить на противоречия. Память лежит отдельно от задачи и переиспользуется всеми ролями сразу: один файл цифр обслуживает и аналитика, и продавца, и автора рассылки.
Второе отличие проявляется при смене модели. Промпт под конкретный интерфейс приходится переписывать, факты о бизнесе переносятся между моделями без единой правки. Для меня это главный практический аргумент: новые релизы выходят постоянно, и переезд на свежий превращается в подключение той же памяти к другому движку. Собранная машина переживает смену деталей, что сильно снижает тревогу от гонки за обновлениями.
Третье отличие касается роста. Когда роль начинает жить долго и обрастать сценариями, разница между разовым промптом и системой становится финансовой - об этом полезно подумать заранее, сравнив варианты собрать самому или взять ИИ-агентов под ключ.
«А если мои данные утекут?»
Вопрос уместный, и разбирается он до того, как файлы заполнены, а не после первого инцидента.
Часть данных в общую память просто не кладут. Персональные данные клиентов, доступы, условия конкретных сделок копирайтеру и маркетологу не нужны почти никогда, им достаточно обобщённых формулировок. Всё чувствительное остаётся там же, где хранилось раньше.
Место хранения выбирается осознанно. Локальная папка на своей машине и корпоративное облако дают разный уровень риска, и решение тут принимается один раз, а не по умолчанию.
Дальше смотришь, какие сервисы получают доступ к этой папке. Условия обработки данных у провайдеров различаются, у платных бизнес-тарифов они обычно строже, чем у бесплатных. Прочитать пользовательское соглашение скучно ровно один раз, и это дешевле любого разбирательства потом.
Практический компромисс: чувствительные цифры заменяются в памяти диапазонами или относительными величинами. Для текста модели хватает знания, что маржа высокая и структура цены такая-то, точное значение до рубля ей не требуется.
Как память растёт вместе с ИИ-командой?
Первый месяц второй мозг обслуживает одну роль, обычно копирайтера или помощника по переписке. Дальше происходит характерный сдвиг: те же файлы начинают использовать другие задачи, и появляется соблазн описать в памяти вообще всё.
Здоровый рост выглядит скромнее. Новый блок заводится тогда, когда конкретная задача трижды упёрлась в его отсутствие. Такой критерий отсекает написание документации ради документации и держит память в размере, который реально прочитывается моделью целиком.
Заодно полезно отслеживать, какие задачи стоит отдавать команде и в каком порядке. Ориентиры я собирал в разборе о том, с каких задач начинать автоматизацию рутины, а общую карту направлений - в материале про автоматизацию бизнес-процессов с ИИ. Отдельная ветка развития проходит через поддержку и переписку с клиентами, где память превращается в источник ответов для чат-бота.
Как это устроено у меня в ежедневной работе, я показываю в закрытом канале ИИмперии.
Где всё равно нужен человек?
Второй мозг снимает механическую часть: пересказ контекста, поиск нужной цифры, попадание в тон, повторное объяснение уже принятых решений. Решения он не принимает и принимать не начнёт.
Куда двигать продукт, какую цену считать справедливой, что публиковать и что придержать, стоит ли брать конкретного клиента - остаётся за тобой. Модель приносит собранный вариант с опорой на твои данные, дальше ты смотришь и решаешь его судьбу. Про экономику этой границы, где ИИ дешевле человека и где выходит наоборот, есть отдельный честный расчёт в разборе о том, когда ИИ дороже живого сотрудника.
Формулировка, к которой я пришёл: он ничего не решает за меня, зато помнит за меня всё, что я боюсь забыть. Думать становится проще, когда нужное лежит под рукой и не выпадает из головы ровно в тот момент, когда понадобилось.
С чего начать на этой неделе?
Час уйдёт на первый шаг: заведи папку, создай три файла, заполни их фактами без украшений, поставь дату в заголовке каждого.
Пятнадцати минут хватит на второй: возьми задачу, которую делаешь регулярно, прогони её через модель с этими файлами и запрети выдумывать недостающее.
Третий шаг растянется на месяцы и почти не потребует усилий. Каждый раз, когда модель спотыкается, дописывай недостающее в память вместо того, чтобы объяснять голосом в чате.
Если хочется пройти этот путь по шагам и с примерами, начни с бесплатного обучения ИИмперии: там разобрана сборка первых ролей и подключение к ним общей памяти. Тем, кто только присматривается к теме, будет полезнее сначала посмотреть вводный разбор про ИИ для малого бизнеса.
Коротко
Второй мозг бизнеса - память, которую ИИ-команда читает вместо того, чтобы каждый раз выспрашивать контекст у тебя. Начинается он с трёх блоков: цифры, продукты и аудитория, тон голоса. Собирается из обычных текстовых файлов за вечер, проверяется на живой задаче и достраивается там, где модель споткнулась. Разделение на стабильный и живой слои снимает главное возражение про быстро меняющийся бизнес, а пометки о неизвестных данных отучают модель фантазировать. Инструменты будут меняться каждый месяц, память остаётся твоей при любой смене инструмента.
Источники
- Building a Second Brain - сайт книги Тиаго Форте о концепции внешней памяти для знаний.
- Forte Labs - блог Тиаго Форте с материалами о продуктивности и организации информации.
- Zettelkasten - описание метода картотеки Никласа Лумана, исторического предшественника идеи внешней памяти.
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - работа Lewis et al. о подключении внешних источников знаний к языковым моделям.
- Lost in the Middle: How Language Models Use Long Contexts - исследование о том, почему информация в середине длинного контекста используется хуже.
Частые вопросы
Чем второй мозг отличается от обычных заметок или базы знаний?
Разница в адресате. Человек, читающий свои заметки, додумывает пропущенное по памяти и контексту, а у модели такого запаса нет. Поэтому во втором мозге каждый факт формулируется явно: цифра с датой, сокращение с расшифровкой, правило с примером.
С чего начать, если времени мало?
Заведи три текстовых файла: цифры, продукты и аудитория, тон голоса. Час работы даёт базу, на которой ИИ перестаёт выдумывать экономику и начинает отвечать по твоему делу.
Нужен ли программист, чтобы это собрать?
Первая версия обходится обычными текстовыми файлами в папке, их пишет владелец бизнеса своими руками. Разработчик пригодится позже, когда захочется подтягивать свежие цифры из CRM автоматически.
Заменит ли второй мозг сотрудников?
Он снимает пересказ контекста, поиск нужной цифры и попадание в тон. Выбор цены, решение о запуске и ответственность за последствия остаются за человеком, и память тут ничего не меняет.
Как часто нужно обновлять память?
Стабильный слой (позиционирование, тон, портрет клиента) переписывают раз в несколько месяцев. Живой слой с ценами и акциями правят по факту изменения, это занимает минуты.