Нейросеть для отчётов: как автоматизировать отчётность
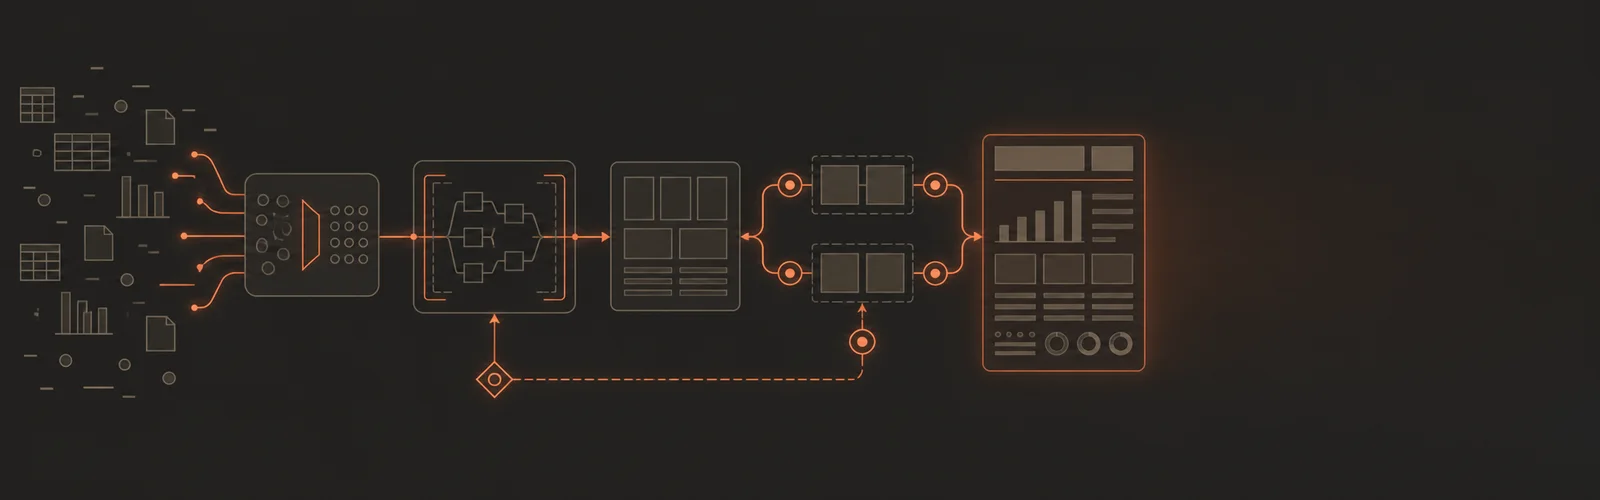
Регулярная отчётность держится на связке из трёх элементов, которые настраиваешь один раз: чистые данные, промпт с правилами и шаблон, куда ложатся выводы. К связке прилагается условие, до которого я дошёл через один испорченный отчёт: арифметику держит таблица, нейросеть только объясняет уже посчитанное.
Пришёл я к этому от усталости. Пятница у меня годами начиналась с одного и того же документа: выгрузки лежали в тех же файлах, логика разбора не менялась, структура текста стояла на месте месяцами. Обновлялись в нём свежие цифры и одна-две фразы про то, что случилось за неделю. Я всё равно садился и собирал документ с чистого листа, будто вижу его впервые.
Потом стало очевидно, чем я на самом деле занят: переписываю то, что уже написал семь дней назад, другими словами.
Ниже разбираю, как связка устроена у меня: из чего собирается, где ломается, какой проверкой я закрываю риск выдуманного числа и в какой момент ручной прогон имеет смысл вешать на расписание.
Почему регулярный отчёт хорошо ложится на нейросеть?
Регулярный отчёт живёт по одному сценарию неделями. Заголовки те же, порядок блоков тот же, набор метрик утверждён когда-то давно и с тех пор никто его не пересматривал. Меняются свежие числа и пара акцентов на событиях периода. Форма остаётся неподвижной, и как раз неподвижная форма делает задачу удобной для языковой модели: структуру придумывать не нужно, нужно аккуратно её наполнить.
Что нейросеть у меня забрала:
- пересборку одинакового текста каждую неделю с нуля;
- перевод сухих чисел в человеческие формулировки («повторные заказы вытянули выручку, хотя новых клиентов пришло меньше»);
- выравнивание тона и формата, чтобы документ читался как отчёт, а сама подача не скакала от недели к неделе;
- первый проход по данным в поисках того, что выбивается из привычного коридора.
Границу обозначу сразу, дальше разберу её подробно: арифметика остаётся снаружи модели. Текст и структуру языковая модель выдаёт отлично, вычисления она имитирует, причём делает это убедительно.
Отчётность вообще неплохой кандидат на первую автоматизацию. Задача повторяется по календарю, результат легко сверить с источником, цена ошибки при нормальной проверке остаётся низкой. Если ты только выбираешь, за что взяться, посмотри разбор про то, с каких задач начинать автоматизацию рутины и подборку про 7 задач для ИИ-ассистента в малом бизнесе: отчётность в обеих стоит в первых рядах.
Как устроена связка данные-промпт-шаблон?
Схема простая до скуки, и её простота как раз и позволяет ей работать долго.
Данные отвечают за факты. Из них берутся все числа, которые попадут в документ, и никаких других чисел в отчёте появиться не должно. Промпт отвечает за поведение: роль, правила, запреты, требуемую структуру ответа. Шаблон отвечает за форму: где стоит резюме, где таблица метрик, где выводы, где следующий шаг.
Сломается любой из трёх элементов - развалится весь прогон, но развалится по-разному. Грязные данные дают правдоподобную чушь. Слабый промпт даёт красивый текст без опоры на цифры. Плавающий шаблон возвращает тебя к ручному причёсыванию, ради избавления от которого всё и затевалось.
У меня эта конструкция сложилась не сразу. Сначала я гонял всё через один длинный запрос: кидал файл, писал «сделай отчёт» и правил результат руками. Правки съедали примерно столько же времени, сколько раньше уходило на сборку, только теперь я ещё и злился на модель. Разделение на три слоя убрало основную часть ручной работы: данные я готовлю в таблице, правила лежат в сохранённом промпте, форма зафиксирована и не обсуждается.
Три слоя полезно держать физически раздельно, а не одним куском текста. У меня промпт с правилами хранится в отдельном файле, шаблон описан там же ниже, а выгрузка каждый раз подставляется в помеченное место. Когда всё слеплено в единый запрос, любая правка формулировки заставляет заново перечитывать простыню целиком, и рано или поздно ты случайно затираешь строку про запрет досчёта. Разделение экономит нервы примерно с третьего цикла.
Отдельно скажу про порядок настройки. Начинать стоит с шаблона, а потом браться за промпт: пока не решил, как выглядит готовый отчёт, ты не сможешь внятно объяснить модели, чего от неё хочешь. Я на этом потерял пару вечеров, пытаясь описать словами документ, которого сам ещё не представлял.
Какие данные и в каком виде отдавать модели?
Модель работает только с тем, что лежит у неё перед глазами. Просьба «посмотри статистику за неделю» отправляет её в свободный полёт, потому что никакой статистики она не видит. Нужна конкретная выгрузка: CSV, кусок таблицы, экспорт из рекламного кабинета, из CRM, из системы учёта. Чем чище вход, тем меньше поводов домысливать.
Мои правила по данным:
- Отдавать посчитанные агрегаты. Итоги, суммы, доли, изменения к прошлому периоду считаю формулами в таблице и передаю модели готовыми. Складывать сырые строки она не должна ни при каких обстоятельствах.
- Всегда прикладывать предыдущий период. Без базы для сравнения любая динамика в отчёте будет придумана. Дал только текущую неделю - получишь фразы вроде «заметный рост», взятые из воздуха.
- Обезличивать чувствительное. Имена клиентов, номера договоров, реальные суммы по конкретным сделкам подменяю на условные, если гоняю данные через публичный сервис.
- Убирать лишние столбцы. Каждый непонятный столбец - это приглашение построить на нём вывод. Оставляю то, что действительно попадёт в отчёт.
- Подписывать единицы измерения. «Выручка, руб.» и «Конверсия, %» экономят целый класс ошибок, где модель принимает проценты за штуки.
- Помечать пропуски явно. Пустая ячейка провоцирует додумывание, надпись «нет данных» - нет.
Формат передачи влияет не меньше содержания. CSV с запятой в русской локали регулярно разъезжается по столбцам, поэтому короткие выгрузки я вставляю markdown-таблицей прямо в промпт, а длинные отдаю файлом. Заголовки столбцов подписываю человеческими словами: «Выручка, руб.» вместо технического rev_sum_w, иначе модель угадывает смысл столбца по соседним значениям и иногда угадывает мимо.
Таблица здесь остаётся главным расчётным инструментом, и это нормально. Excel и Google Sheets десятилетиями умеют то, чему языковую модель учить бессмысленно. Про разделение обязанностей между формулами, макросами и нейросетью я подробно писал в тексте про автоматизацию Excel: макросы и VBA против ИИ, там же разобрано, что имеет смысл оставить скриптам.
Если отчёт опирается не только на цифры, но и на постоянный контекст (список продуктов, расшифровка метрик, принятые в компании термины), этот контекст удобнее держать отдельно от выгрузки и подключать к промпту как справочник. Механика описана в разборе про то, как дать нейросети базу знаний.
Если разбираться в связках самому пока тяжело и хочется, чтобы кто-то показал порядок действий на живых примерах, у нас есть бесплатное обучение по нейросетям для работы: разбираем подготовку данных, промпты и типовые сценарии автоматизации без предварительной подготовки со стороны участника.
Как выглядит скелет промпта для отчёта?
Промпт задаёт роль, правила и границы. Здесь же я закладываю защиту от вранья, потому что позже её вставлять некуда. Вот рабочий скелет, который адаптируется под любой регулярный отчёт:
Ты - аналитик. Твоя задача - собрать недельный отчёт по продажам
на основе данных ниже.

ЖЁСТКОЕ ПРАВИЛО: используй только те числа, что есть в данных.
Ничего не досчитывай и не округляй по своему усмотрению.
Если для вывода не хватает цифры - напиши "нет данных", не выдумывай.
Для каждого числа в тексте укажи, из какой строки данных ты его взял.

Данные:
[сюда вставляешь выгрузку с итогами за эту и прошлую неделю]

Сделай:
1. Короткое резюме недели (2-3 предложения).
2. Таблицу: метрика | эта неделя | прошлая неделя | изменение.
3. Три вывода: что выросло, что просело, на что обратить внимание.
4. Один вопрос, ответ на который тебе нужен для более точного вывода.

Тон: спокойный, по делу, без превосходных степеней.
Разберу, зачем тут каждый кусок.
Роль в первой строке сужает словарь и манеру изложения. Без неё модель легко сваливается в маркетинговый тон с «впечатляющей динамикой», который в отчёте руководителю смотрится нелепо.
Блок «ЖЁСТКОЕ ПРАВИЛО» заметно снижает количество выдуманных значений. Явный запрет с готовой альтернативой («напиши нет данных») работает лучше, чем молчаливая надежда на аккуратность. Ошибиться модель всё равно способна, поэтому проверка остаётся за тобой.
Требование указывать строку-источник для каждого числа - самая полезная строчка во всём промпте. Выдуманную цифру привязать не к чему, и она всплывает мгновенно.
Последний пункт про вопрос я добавил позже. Модель почти всегда находит место, где данных не хватает, и вместо тихого домысливания честно спрашивает. Половина моих улучшений в выгрузке выросла именно из этих вопросов.
Ещё одна строка появилась у меня после третьего цикла: порог значимости. Без него ростом объявляется любое движение вверх, включая полпроцента внутри обычного шума, и отчёт наполняется событиями, которых не было. Формулировка выглядит так: «Изменение меньше 5% считай колебанием и не выноси в выводы, если оно не повторяется второй период подряд». Величину порога каждый подбирает под свои данные, у недельной выручки коридор шума шире, у конверсии в заявку заметно уже.
Формулировки для аналитической части - отдельное ремесло. Какие вопросы вообще стоит задавать своим данным, чтобы получать выводы вместо пересказа таблицы, я разбирал в материале про ИИ для бизнес-аналитики.
Модель под отчёты я выбираю по двум признакам: как она держит длинный контекст и насколько дисциплинированно следует запретам. Сравнение по этим критериям есть в тексте Claude или ChatGPT: что выбрать под задачу, а вопросы доступа из России разобраны в инструкции про то, как пользоваться Claude из России.
Зачем регулярному отчёту жёсткий шаблон?
Шаблон - фиксированная форма отчёта, куда ложатся выводы. Пока структура у меня плавала от недели к неделе, основное время уходило на причёсывание: тут заголовок другой, там таблица шире, здесь выводов пять вместо трёх. Модель каждый раз предлагала свежий вариант оформления, а я каждый раз возвращал документ к привычному виду.
Опиши структуру один раз и требуй её в каждом прогоне. Мой стандартный набор блоков:
- Шапка. Период, кто собрал, дата сборки.
- Резюме. Два-три предложения для того, кто дальше читать не будет.
- Таблица метрик. Метрика, текущий период, предыдущий, изменение.
- Что выросло. Один абзац с объяснением причины.
- Что просело. Один абзац, обязательно с гипотезой.
- На что смотреть дальше. Одно конкретное действие или наблюдение.
- Оговорки. Всё, где данных не хватило.
В шаблоне я задаю ещё и объём: сколько предложений в резюме, сколько абзацев на блок. Без ограничения по длине модель раздувает выводы до размера, при котором их перестают читать, и полезное наблюдение тонет среди вежливых общих фраз. Жёсткая рамка вроде «не больше четырёх предложений на блок» заставляет её выбирать главное, а выбор главного как раз и есть работа аналитика.
Блок оговорок я держу принудительно. Раньше нехватка данных растворялась внутри выводов и незаметно превращалась в утверждение, теперь она собрана в одном месте и видна на глаз.
Со временем шаблон перерастает в регламент роли: там оказываются не только блоки отчёта, но и запреты, тон, типовые формулировки, порядок проверки. Как из такого набора правил вырастает полноценная рабочая роль, я разбирал отдельно в материале «Как собрать ИИ-сотрудника с нуля». У аналитика регламент один, у продавца или копирайтера совершенно другой, но принцип сборки общий.
Как собрать первый отчёт за один вечер?
Порядок действий, который я советую всем, кто начинает:
- Выгрузи данные. Итоги за текущий и прошлый период в таблицу или CSV. Убедись, что суммы посчитаны формулами, а не набиты руками.
- Опиши форму. Накидай блоки будущего отчёта прямо в текстовом файле. Пять минут работы, которые потом сэкономят вечер.
- Собери промпт по скелету выше. Роль, жёсткое правило, данные, требуемая структура, требование указывать источник каждого числа.
- Прогони и сверь. Возьми две-три ключевые цифры из ответа и сравни с таблицей руками. Ключевые - это те, на которые смотрит заказчик отчёта в первую очередь.
- Почини промпт, а не текст. Всё, что не понравилось в результате, правь на уровне инструкции. Ручная правка живёт ровно один прогон, правка промпта переносится на все следующие.
- Зафиксируй заготовку. Когда формат устроил, сохрани промпт целиком, чтобы дальше менять только блок с данными.
- Прогони так три-четыре раза подряд. Стабильность видна только на серии, на одном удачном запуске её не проверить.
Шаги 4 и 5 пропускать нельзя, хотя соблазн велик: первый ответ модели обычно выглядит настолько прилично, что проверять его не хочется. Ровно из-за этой приличности и попадают в документы выдуманные проценты.
Где нейросеть врёт в цифрах отчёта?
Врёт она в трёх предсказуемых местах.
Первое - проценты изменения. Если ты дал абсолютные значения за два периода, но не дал разницу, модель посчитает её сама, и посчитает как получится. Второе - итоги по строкам и группам. Пропущенная сумма по каналу или категории превращается в правдоподобное число, подогнанное под соседей. Третье - пробелы в данных. Отсутствующее значение модель заполняет тем, что укладывается в общий тренд, и это выглядит естественнее правды.
Общее у всех трёх мест одно: там требуется арифметика.
Механика сбоя понятна, если помнить природу инструмента. Языковая модель предсказывает правдоподобное продолжение текста, и число внутри предложения для неё такая же часть текста, как прилагательное. Уверенный процент роста она напишет спокойным ровным тоном, без единого признака сомнения. Внешне такой вывод выглядит даже солиднее верного, потому что в нём нет оговорок. Именно этим он и опасен.
Как я держу риск под контролем:
| Приём | Что делает |
|---|---|
| Считать вне модели | Все суммы и проценты - формулами в таблице, модели даёшь готовое |
| Правило «не выдумывай» | Явный запрет в промпте досчитывать и заполнять пробелы |
| Ручная сверка 2-3 цифр | Быстрая проверка ключевых чисел перед отправкой |
| «Нет данных» вместо догадки | Модель обязана признавать нехватку вместо подстановки числа |
| Просьба показать источник | «Для каждой цифры укажи, из какой строки данных ты её взял» |
| Блок оговорок в шаблоне | Собирает все места нехватки в одном видимом списке |
| Повторный прогон на тех же данных | Расхождение между двумя ответами показывает нестабильные места |
Последние два приёма выручают чаще остальных. Повторный прогон особенно нагляден: если одна и та же выгрузка дважды дала разные числа, ошибка сидит в данных или в промпте, и искать её нужно там.
Разбор случая: канал, который посчитал себя сам
История, после которой у меня появилось правило про ручную сверку.
Я готовил сводку по продажам за две недели и собирал выгрузку в спешке. В таблицу попали строки по всем каналам, но итоговая сумма по одному из них потерялась при копировании: строка визуально была на месте, значение в ней отсутствовало.
Модель отработала безупречно с точки зрения текста. Она выдала резюме, таблицу и три вывода, и в выводах спокойно сообщила, что потерянный канал вырос на вполне конкретную величину. Процент выглядел логично: он ложился в общую динамику остальных каналов, не выбивался ни в одну сторону, читался как самое обычное наблюдение. Глаз за него не зацепился ни при первом чтении, ни при втором.
Спасла привычка сверять ключевые числа руками. Общий итог по всем каналам в отчёте не сошёлся с итогом в таблице, и разница указала прямо на проблемную строку. Дальше стало видно, что модель просто дорисовала недостающее значение так, чтобы сумма выглядела правдоподобно.
Починка заняла минут двадцать. В пустую ячейку я вписал явную пометку об отсутствии данных, а в промпт добавил требование выводить контрольную сумму по всем каналам отдельной строкой, чтобы расхождение вылезало само и без моей арифметики. Следующий прогон на той же выгрузке честно поставил «нет данных» напротив проблемного канала и вынес пропуск в блок оговорок, где его невозможно не заметить.
Три вывода я тогда записал и с тех пор не нарушаю.
Первый: проверять надо итоги, а не отдельные красивые цифры. Расхождение почти всегда всплывает именно в сумме.
Второй: пустая ячейка опаснее отсутствующей строки. Строки на месте достаточно, чтобы модель сочла её значимой и заполнила.
Третий, самый неприятный на вкус: найденную ошибку нельзя править руками в готовом тексте. Ручная правка чужой галлюцинации тихо приучает доверять сломанному процессу, а через месяц ты уже не помнишь, в каком отчёте что подкручивал. Чинить нужно данные или промпт, после чего прогонять заново.
Когда переносить отчёт на расписание?
Ручной прогон означает, что ты каждый раз вставляешь выгрузку и копируешь результат. Автоматический означает, что связка «данные - промпт - готовый документ» срабатывает сама по календарю, а тебе приходит уведомление.
Переходить ко второму варианту стоит после того, как выполнены три условия: формат отчёта не менялся несколько циклов подряд, ручные прогоны перестали требовать правок, и ты понимаешь, что делать с ошибкой, если она случится в твоё отсутствие. Автоматизация неотлаженного процесса просто ускоряет производство брака.
Технически связка собирается на низкокодовых платформах. Сценарий выглядит так: по расписанию забрать выгрузку из источника, прогнать через модель с сохранённым промптом, положить результат в документ или прислать в мессенджер. Как собрать первый такой сценарий с нуля, разобрано в пошаговом руководстве про то, как освоить n8n с нуля. Кому ближе код, тот же путь проходится скриптом, и границы этого подхода я описывал в тексте про автоматизацию рутины на Python.
Перед переносом на расписание заведи версии промпта. Я держу его в текстовом файле, рядом ставлю дату изменения и строку о том, что именно поменял. Когда через месяц отчёт вдруг начинает выглядеть иначе, история правок отвечает быстрее, чем перебор гипотез в голове.
Когда отчёт начинает сам ходить за данными, принимать решения о повторных запросах и реагировать на аномалии, он перестаёт быть сценарием и становится агентом. Разница между этими двумя вещами разобрана в материале про ИИ-агентов для бизнеса, и прыгать в агентов сразу я никому не советую: отлаженный линейный сценарий даёт девяносто процентов пользы при доле сложности.
Отдельно про мониторинг. У автоматического отчёта обязательно должен быть сигнал о сбое: пустая выгрузка, недоступный источник, ответ модели непривычной длины. Молчаливая поломка в автоматизации хуже громкой, потому что документ продолжает приходить и выглядеть нормально.
Сколько это экономит и когда не окупается?
Экономия появляется на повторах. Первый прогон обходится дороже ручной сборки: ты пишешь промпт, споришь с формулировками, ловишь первые галлюцинации. Со второго-третьего цикла картина меняется, потому что меняется только блок с данными, а роль, правила и форма уже зашиты.
На чём именно уходит время в мою пользу: пропадает чистый лист, пропадает подбор формулировок, пропадает выравнивание оформления. Остаётся подготовка выгрузки и проверка, и вот они никуда не денутся.
Где связка не окупается:
- Разовый отчёт. Настройка съест больше, чем сборка руками.
- Постоянно меняющаяся структура. Если каждый период набор метрик другой, шаблон не успевает застыть.
- Данные, которые нельзя выносить наружу, пока не решён вопрос контура обработки.
- Отчёт из двух абзацев. Автоматизировать там нечего.
- Процесс, где сбор данных сам по себе занимает основное время. Тогда чинить надо сбор, а не текст.
Разложить свои процессы по этой логике помогает карта возможностей автоматизации бизнес-процессов с ИИ: она показывает, какие участки вообще стоит трогать первыми. Если ты только присматриваешься к теме и бюджет ограничен, начни с обзора ИИ для малого бизнеса: с чего начать.
Возражения, которые я слышу чаще всего
«Проще посчитать вручную, чем всё это настраивать». На один отчёт - действительно проще. Вопрос в том, разовая это задача или возвращающаяся по календарю. Недельная отчётность за квартал набирает больше десятка повторов, и каждый из них после настройки стоит дешевле предыдущего ручного.
«Модель врёт, значит инструмент негодный». Врёт она предсказуемо и в известных местах, а предсказуемая ошибка лечится процедурой. Калькулятор тоже выдаёт чушь, если нажать не ту кнопку; разница в том, что за нейросетью нужна дисциплина проверки вместо слепого доверия.
«У нас конфиденциальные данные». Обезличивание закрывает большинство сценариев: модели для интерпретации нужны структура и порядок величин, настоящие фамилии и номера договоров ей ни к чему. Там, где обезличить нельзя, разговор переходит в плоскость выбора контура обработки, и решать это надо до первого прогона.
«Руководитель не примет отчёт, написанный нейросетью». Он примет отчёт, который верен и понятен. Ответственность за содержание остаётся на тебе в любом случае, инструмент сборки заказчика документа обычно не волнует.
«Мы пробовали, получилась ерунда». В девяти случаях из десяти пробовали одним запросом «сделай отчёт по этому файлу», без подготовленных агрегатов, без правил и без формы. Ерунда в такой конфигурации гарантирована.
«Это же можно поручить стажёру». Можно, и стажёр справится. Отчёт при этом всё равно придётся проверять, а стажёр вдобавок устаёт, уходит в отпуск и увольняется, унося с собой знание процесса. Регламент в промпте не увольняется.
«Модели обновляются, промпт перестанет работать». Обновление действительно сдвигает манеру ответа: длину абзацев, тягу к спискам, аккуратность с форматом таблицы. Выручает та же серия прогонов: после смены версии я гоняю связку на старой выгрузке, ответ по которой знаю наизусть, и сравниваю с сохранённым отчётом. Жёсткие правила про числа переживают обновления лучше всего, страдает обычно оформление, а его поправить дёшево.
«Отчёт всё равно читают два человека». Настройка окупается как раз на скучных документах, которые никто не хвалит. Чем меньше внимания к отчёту, тем выше шанс, что ошибка в нём спокойно проживёт несколько месяцев.
Что в отчёте остаётся за человеком?
Черновик и рутину нейросеть снимает целиком. Дальше начинается зона, куда её пускать не стоит.
Решение о действиях по цифрам принимает человек: что делать с провалом по каналу, стоит ли резать бюджет, кого предупредить заранее. Подача материала конкретному читателю тоже человеческая работа, потому что модель не знает контекста отношений с заказчиком отчёта и его болевых точек. Ответственность за отправленный документ вообще не делится: подписывается под ним живой человек.
Полезнее всего думать о модели как о быстром младшем аналитике, за которым всегда проверяет старший. Старший здесь ты, и снять с себя эту роль не получится, даже когда прогон полностью автоматизирован.
Соотношение между таким помощником и полноценной ролью в команде я разбирал в материале про то, что такое цифровой сотрудник и чем он отличается от обычного чат-бота. Отчётный аналитик - один из самых понятных примеров такой роли, потому что у него измеримый результат и очевидная процедура проверки.
Чек-лист перед отправкой отчёта
Пробегаю по нему каждый раз, занимает пару минут:
- Итоговые суммы в отчёте сходятся с итогами в исходной таблице.
- Две-три ключевые метрики сверены с источником вручную.
- Каждое число в тексте привязано к строке данных.
- Блок оговорок заполнен или явно пуст.
- Формулировок в превосходной степени нет.
- Период и дата сборки указаны в шапке.
- Персональные и коммерчески чувствительные данные обезличены там, где это требуется.
- Все правки внесены в промпт, а готовый текст оставлен в покое.
Если собираешь не один отчёт, а полноценного цифрового аналитика с регламентом, готовыми промптами и связками под свои данные, такие разборы и шаблоны ролей мы выкладываем в закрытый канал ИИмперии. Там же лежат рабочие промпты, которые не приходится собирать с нуля.
Отчётность остаётся удобной первой задачей для автоматизации: повторяемая, измеримая, с легко проверяемым результатом. Настрой связку один раз, отладь её на серии ручных прогонов, и пятница перестанет начинаться с чистого листа. У меня перестала.
Источники
- Anthropic - Reduce hallucinations - приёмы, которые снижают выдумки модели: явные запреты, разрешение отвечать «нет данных», требование ссылаться на источник.
- Anthropic - Prompt engineering overview - базовые правила формулировки инструкций: роль, чёткие границы задачи, требуемая структура ответа.
- OpenAI - Prompt engineering guide - как задавать инструкции, чтобы модель шла по заданным правилам и не досчитывала по своему усмотрению.
- n8n - официальная документация - справочник по сценариям, расписаниям и подключению источников данных для автоматического прогона отчёта.
Частые вопросы
Можно ли доверить нейросети считать финансовые цифры?
Считать - нет, суммы и проценты надёжнее считать формулами в таблице. Модели отдай интерпретацию: что выросло, что просело и почему это важно.
Как понять, что нейросеть выдумала число в отчёте?
Возьми 2-3 ключевые цифры и сверь с исходной таблицей вручную. Если хоть одна не сходится, её лучше не править руками; поменяй промпт, ведь обычно модель досчитывает то, чего в данных нет.
Нужен ли отдельный сервис или хватит обычного чата?
Для старта хватит чата с загрузкой файла. Автоматизацию по расписанию через n8n или Make подключай, когда ручной прогон уже отлажен и стабилен.
Заменит ли это аналитика?
Нет. Рутину сборки и первый черновик выводов - да, но решения по цифрам, проверку и ответственность за отчёт человек оставляет за собой.
Сколько времени занимает настройка связки?
Первый рабочий прогон реально собрать за вечер: выгрузка, промпт по скелету, ручная сверка. Доводка формулировок обычно растягивается на два-три отчётных цикла, пока шаблон не перестаёт хотеть правок.
Что делать, если данные конфиденциальные?
Обезличивать перед отправкой: подменять имена клиентов, номера договоров и реальные суммы на условные. Для боевых данных без обезличивания нужен контур, который согласован с вашими правилами по безопасности.