Нейросеть для аналитики данных: собрать ИИ-аналитика
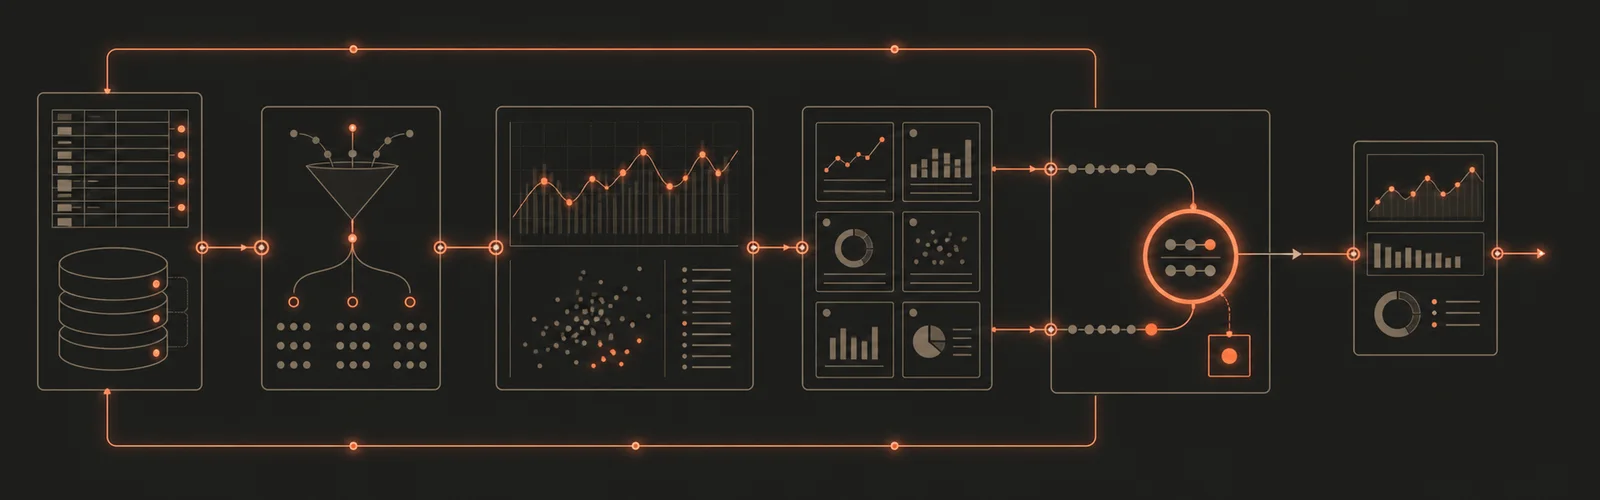
ИИ-аналитик собирается из трёх вещей: чистая выгрузка данных, регламент вопросов к ним и процедура проверки ответа. Мощность самой модели стоит в этом списке последней по важности. Дал файл, задал рамку «метрика + период + разрез», потребовал формулу к каждой цифре, сверил главное число руками - роль поехала.
Первый раз я посадил модель считать свои цифры примерно так: скинул выгрузку продаж и спросил, что тут не так. Через минуту вернулась аккуратная сводка с процентами, выводами и рекомендациями, всё складно и уверенно. Часть цифр в ней была придумана, и я потратил ещё полчаса, чтобы понять, какая именно часть.
С тех пор я перестал ждать от модели готовый вывод. Беру черновик, который могу разобрать по косточкам, и уже это меняет и уровень доверия, и результат на выходе.
Что умеет ИИ-аналитик, а что нет?
Аналитик в бизнесе отвечает на один вопрос: что происходит с цифрами и почему. Механическую часть этой работы нейросеть закрывает хорошо.
Что она берёт на себя:
- посчитать метрики из выгрузки (выручка, средний чек, конверсия, отток);
- найти аномалии, где резко просело или выросло;
- сгруппировать и отсортировать: топ товаров, худшие каналы, сегменты клиентов;
- собрать черновик отчёта человеческим языком;
- предложить гипотезы, почему цифра изменилась;
- написать формулу для таблицы или SQL-запрос под конкретный срез.
На человеке остаётся:
- решить, какой вопрос вообще важен сейчас для дела;
- проверить, что данные не врут (пропуски, дубли, кривой период);
- принять решение по итогу и ответить за него деньгами.
Модель не «понимает» твой бизнес. Внутри у неё предсказание правдоподобного текста, поэтому уверенная интонация есть всегда, а верность цифры зависит от того, что ты положил на вход и о чём попросил. Отсюда и весь мой подход к роли: регламент, который делает вывод проверяемым, важнее выбора между топовыми моделями. Без такого каркаса даже самая сильная модель выдаёт гладкие сводки, которые нечем подтвердить.
Такая роль хорошо ложится в общую логику цифрового сотрудника: узкая зона ответственности, понятный вход, понятный выход и человек, который принимает работу.
Шаг 1. Как дать данные, а не скриншоты?
ИИ-аналитик начинается с выгрузки. Сначала файл с данными за период, и только потом вопросы к нему. Брошенное в чат «а как у меня с продажами» без цифр внутри вернёт общие слова про воронку.
- Выгрузи данные за нужный период в CSV или таблицу: дата, метрика, категория. Один чистый источник полезнее пяти подключённых, но грязных.
- Убери персональные данные. В облачную модель грузим агрегаты и суммы, без имён, телефонов и карт клиентов.
- Назови колонки понятно.
revenue,channel,dateчитаются моделью лучше, чемстолбец3иUnnamed: 7. - Дай плоскую таблицу. Объединённые ячейки, шапка на трёх уровнях и подытоги внутри данных сбивают разбор: модель принимает строку «Итого» за обычный заказ и складывает её со всеми остальными.
- Приведи даты к одному формату, лучше
2026-07-14. Смесь из14.07.26иJul 14даёт разное разбиение по неделям.
Ещё одна мелочь, которая экономит время: клади в файл только те колонки, которые нужны для вопроса. Лишние поля не улучшают ответ, зато раздувают объём и дают модели поводы уйти в сторону от того, что тебя интересует.
Скриншот дашборда вместо файла работает плохо. Модель распознает картинку, часть цифр прочитает с ошибкой, и ты об этом не узнаешь, потому что проверить нечего. Если данных много и они живут в базе, роль подключают к ней через отдельного read-only пользователя: так она может только читать и физически не способна ничего испортить. Доступ выдаётся ровно под задачу, без запаса «на всякий случай».
Когда выгрузка совсем большая, разумнее сначала свернуть её скриптом до дневных агрегатов и уже агрегат отдавать модели. Это ровно та рутина, про которую я писал в разборе автоматизации на Python: десять строк кода экономят половину ручной подготовки.
Шаг 2. Как научить её задавать вопросы данным?
Главный навык аналитика прячется в умении правильно спросить. Считать модель и так умеет, ценность появляется в формулировке задачи. Размытый вопрос даёт гладкий и бесполезный ответ, и на этом я обжигался чаще всего.
Сравни два запроса к модели:
| Слабый вопрос | Сильный вопрос |
|---|---|
| «Проанализируй мои продажи» | «Посчитай выручку по неделям за квартал. Покажи недели, где падение к предыдущей заметно больше остальных» |
| «Как дела с рекламой?» | «Сравни стоимость заявки по каналам. Отсортируй от дорогого к дешёвому, добавь долю в общем бюджете» |
| «Почему упала прибыль?» | «Прибыль в июле ниже июня. Разложи разницу: что дала цена, что объём, что расходы» |
| «Найди инсайты» | «Покажи топ-10 товаров по выручке и топ-10 по марже. Выдели те, что попали в один список и пропали из другого» |
Сильный вопрос держит три вещи: метрику, период и разрез. Заложи это в регламент роли - короткий текст-инструкцию, которую ты даёшь модели в начале каждой сессии: «Ты аналитик. Прежде чем считать, уточни период и разрез. Каждую цифру сопровождай формулой или SQL-запросом, которым ты её получил».
Последнее сильно экономит нервы. Модель, показывающая, как она получила число, ловится на ошибке в разы легче той, что выдаёт голый итог. Подробнее про сами вопросы к бизнес-данным я разбирал в материале ИИ для бизнес-аналитики: какие вопросы задать.
Работает и обратный ход: попроси модель саму предложить пять вопросов к твоей выгрузке, глядя на состав колонок. Половина окажется банальной, но одна-две обычно указывают на срез, до которого ты не додумался, потому что смотрел на данные привычным взглядом. Выбранный вопрос дальше формулируешь уже сам, по правилу «метрика, период, разрез».
Ещё один приём, который стоит зашить в регламент: право модели сказать «не знаю». Явное разрешение отвечать «в данных нет этой информации» снижает долю выдуманного заметно сильнее, чем угрозы в промпте.
Если хочешь собрать такую роль под свои задачи и не набивать шишки поодиночке, у нас открыто бесплатное обучение по цифровым сотрудникам: там сборка разобрана по шагам, с готовыми регламентами и примерами промптов под аналитику.
Шаг 3. Где нейросеть врёт на цифрах и как это ловить?
Нейросеть ошибается тихо и убедительно. Вот места, где я ловил её на неверном выводе.
Придумывает цифры. Если в данных дырка, модель дорисует правдоподобное число вместо честного «данных нет». Лечится требованием показывать источник каждой цифры и прямым запретом додумывать недостающее.
Путает корреляцию и причину. «Продажи выросли, потому что запустили рассылку», а на деле совпало с сезоном. Модель охотно выдаёт причину, которой в данных нет. Моя работа тут одна: спросить, что ещё менялось в этот период. Ловушка старая, человеку она свойственна не меньше, чем машине, просто машина формулирует убедительнее.
Берёт кривой период или дубли. Неделя может быть посчитана с понедельника вместо воскресенья, а заказ учтён дважды из-за возврата и повторной оплаты. Итог сдвигается, а выглядит нормально, потому что порядок величин совпадает с ожидаемым.
Средние скрывают правду. Средний чек вырос за счёт пары крупных сделок, тогда как масса клиентов просела. Проси рядом со средним медиану и разброс между минимумом и максимумом. Часто именно медиана показывает, что рост коснулся единиц.
Сравнивает неполный период с полным. Текущий месяц идёт четырнадцатый день, а модель сопоставляет его с целым прошлым месяцем и рапортует о падении вдвое. Требуй сравнения сопоставимых отрезков: день к дню, неделя к неделе.
Теряет знак и масштаб. Возвраты приходят отрицательными суммами, скидки лежат в отдельной колонке, комиссия площадки вычитается позже. Проговори один раз в регламенте полный состав выручки, иначе каждый новый запуск даёт своё определение.
Проценты от процентов. Конверсия выросла с 2% до 3%, и модель называет это ростом на 1%, хотя относительный рост тут в полтора раза. Полезно просить обе величины сразу: пункты и проценты.
Как я проверяю, чтобы не принять неверный вывод:
- Сверь одну цифру руками. Возьми самую важную метрику из отчёта и пересчитай её в таблице. Совпало - доверия к остальному больше.
- Спроси формулу. «Покажи, как ты посчитал эту цифру». Внятного объяснения нет - число под подозрением.
- Проверь на здравый смысл. Выручка подскочила в разы за неделю без причины? Скорее всего, где-то сломалась выгрузка.
- Задай контр-вопрос. «Какие ещё объяснения у этого падения, кроме рекламы?» Если модель легко находит другое, первый вывод был поспешным.
- Проверь сумму частей. Разрезы по каналам должны складываться в общий итог. Расхождение означает потерянные или задвоенные строки.
Вывод готовит нейросеть, а принимает его всегда человек. Ни одно решение о деньгах не уходит в дело только потому, что так сказала модель. Контроль здесь сводится к способности видеть картину целиком и понимать, где копнуть. Пересчитывать вручную каждую цифру при этом незачем.
Как разобрать падение прибыли по шагам?
Разберу типовую задачу, ради которой роль обычно и собирают: прибыль за месяц ниже предыдущего, причина неочевидна.
Первым делом я запрещаю модели отвечать одной фразой. Вопрос ставится как разложение: прибыль складывается из цены, объёма и расходов, значит просадку нужно разнести по этим трём составляющим и показать вклад каждой в рублях. Пока ответ не разложен, обсуждать нечего.
Полезно сразу увидеть такое разложение на числах. Условный пример с круглыми суммами: выручка месяца 3 400 000 против 4 000 000 в предыдущем. Разница разносится так: проданных единиц стало на 15% меньше, и это забирает 600 000; средняя цена подросла на 4% и возвращает 150 000; подорожавшая доставка съедает ещё 150 000. Сумма частей совпала с фактической просадкой, и дальше разговор идёт уже про объём продаж. Когда разложение с итогом не сходится, в выгрузке потерялись строки, и лечить надо сначала данные.
Дальше идёт разрез по каналам и категориям. Часто общая просадка живёт в одном сегменте, а остальные держатся ровно: тогда вопрос сужается до «что случилось с этим сегментом», и половина гипотез отваливается сама.
Календарь я смотрю третьим. Сколько было рабочих дней, куда попали праздники, не пришлась ли просадка на одну конкретную неделю. Бывает, что весь эффект дают четыре дня, когда лежала оплата или была отключена реклама.
Затем наступает очередь контр-гипотез. У модели запрашиваю три альтернативных объяснения к тому, что она назвала главной причиной, плюс признак, по которому каждое можно проверить в данных. Из этого списка я выбираю, что проверять руками, и обычно на проверку уходит одна выгрузка и десять минут.
Решение остаётся за мной, и звучит оно как действие: вернуть бюджет в канал, поднять цену в категории, разобраться с логистикой. Там, где начинается ответственность за деньги, любой аналитик остаётся только советчиком.
Последнее, что стоит сделать по итогам разбора, - записать его. Три строки в заметке: что просело, чем объяснилось, что решили. Через полгода такие записи складываются в маленькую историю бизнеса, и следующий похожий провал разбирается вдвое быстрее, потому что список подозреваемых уже готов.
Шаг 4. Как собрать отчёт по шаблону?
Чтобы ИИ-аналитик работал стабильно, зафиксируй формат отчёта и подавай его вместе с задачей. Дай модели шаблон:
- Что смотрели - метрика, период, разрез.
- Главная цифра - и рядом формула или запрос.
- Что изменилось - к прошлому периоду, в процентах и в абсолюте.
- Аномалии - где резко и почему стоит копнуть.
- Гипотезы - каждая с явной пометкой «гипотеза».
- Что проверить руками - список цифр под сверку.
- Чего в данных нет - ограничения выгрузки, о которых нельзя забывать при трактовке.
Последний пункт я добавил позже остальных, и он оказался самым полезным. Модель, обязанная перечислить слепые зоны, реже подаёт частичную картину как полную.
Такой шаблон превращает разовый чат в повторяемого сотрудника. Держи его рядом с базой знаний для нейросети - хранилищем, где живут твои метрики, продукты и определения. Тогда аналитик знает, что средний чек у тебя считается вот так, а отток вот эдак, и не переспрашивает каждый раз заново.
Что писать в регламенте роли?
Регламент - это текст на половину страницы, который ты вставляешь первым сообщением. Мой каркас выглядит примерно так:
Ты аналитик данных. Работаешь только с приложенной выгрузкой, внешние источники не используешь. Перед расчётом уточни метрику, период и разрез, если они не заданы. К каждой цифре давай формулу или SQL, которым она получена. Если данных для ответа не хватает, пиши «данных нет» и указывай, какой колонки не хватает. Гипотезы помечай словом «гипотеза». В конце дай список цифр, которые стоит проверить вручную. Не округляй суммы до тех пор, пока я не попрошу.
Дальше он обрастает твоей спецификой: определения метрик, список каналов, валюта, что считать тестовым заказом. Отдельно стоит прописать тон отчёта, иначе на выходе получишь консалтинговую презентацию вместо рабочей записки.
Общая логика сборки такой инструкции ничем не отличается от других ролей, я расписывал её в материале как собрать ИИ-сотрудника с нуля. Аналитик просто требовательнее к проверке, потому что цена ошибки измеряется деньгами.
Как понять, что роль реально работает?
Через месяц полезно посмотреть на роль целиком, и тут выручают четыре наблюдения.
Веди короткий список цифр, которые не сошлись при ручной сверке. Он либо сокращается от недели к неделе, либо замирает на месте, и второе означает дыру в регламенте, а не полосу невезения.
Повторяемость проверяется просто: задай тот же вопрос в новой сессии через неделю. Расхождение при неизменных данных говорит, что где-то не зафиксировано определение метрики или границы периода.
Время меряй интервалом от возникшего вопроса до цифры, которой ты веришь. Скорость самой модели тут почти ни на что не влияет, а вот этот интервал роль сокращает заметно, им же окупается возня со сборкой.
Есть и побочный эффект, заметный не сразу: дешёвый доступ к разрезам меняет привычку смотреть на цифры. Вопросов становится больше, задаются они чаще, и проблемы всплывают раньше, чем при ежемесячном ритме отчётности.
Что делать, если данные грязные?
Идеальной выгрузки не бывает, и это нормально. Разбираться приходится с одним и тем же набором проблем.
Дубли. Один заказ приходит двумя строками из-за повторной оплаты или синхронизации между сервисами. Попроси модель проверить уникальность идентификатора заказа и показать примеры повторов, прежде чем считать сумму.
Разные названия одного канала. Яндекс.Директ, yandex direct, директ в одной колонке превращаются в три канала. Нормализацию делают справочником: список соответствий, который лежит рядом с выгрузкой.
Тестовые и внутренние заказы. Свои же проверки платежей раздувают выручку. Их отсекают по признаку или по списку идентификаторов, и это правило тоже живёт в регламенте.
Пропуски. Пустая ячейка в сумме и ноль - разные вещи. Явно скажи модели, как трактовать пустоту, иначе она выберет вариант сама и не сообщит об этом.
Часовые пояса и валюты. Заказ, оформленный в 23:50 по Москве, в UTC уезжает на следующий день. Продажи в разных валютах без курса на дату сравнивать бессмысленно.
Съехавшая структура файла. Сервис добавил колонку или переименовал старую, и регламент, написанный под прошлый формат, тихо разъезжается. Раз в пару месяцев проси модель описать состав выгрузки своими словами и сверяй описание с тем, что ожидаешь там увидеть.
Большая часть этой чистки делается в таблице до всякой нейросети. Про границу между формулами, макросами и моделью я писал отдельно в разборе Excel, макросы, VBA против ИИ: часть задач дешевле закрыть сводной таблицей и не звать модель вообще.
Что нельзя грузить в облачную модель?
Граница простая: всё, по чему можно опознать конкретного человека, остаётся у тебя. Имена, телефоны, почты, адреса, номера карт и паспортов в чат не уезжают. Работа идёт с агрегатами: суммы, количества, доли, идентификаторы без расшифровки.
Обработка персональных данных в России регулируется 152-ФЗ, и передача их стороннему сервису без оснований создаёт вполне осязаемый риск для компании. Практический выход - обезличивание на этапе выгрузки: клиент превращается в номер, город остаётся, контакты не выгружаются вовсе.
Проверить стоит и настройки самого сервиса: у большинства провайдеров в платных тарифах есть переключатель, запрещающий использовать переписку для обучения. Режим обучения на чатах, включённый по умолчанию, - лишний довод против того, чтобы кидать туда сырые клиентские базы.
Для чувствительных данных остаётся вариант с локальной моделью на своём железе, но начинать с него я никому не советую. Сначала имеет смысл проверить, что роль вообще приносит пользу на обезличенных агрегатах, а вопрос размещения решать потом.
Отдельная тема - доступ к базе. Read-only пользователь с правами только на нужные таблицы закрывает большую часть страхов: даже кривой запрос ничего не удалит.
Где живёт ИИ-аналитик: чат, таблица или автоматизация?
Стартовать проще всего в чате: файл, регламент, вопрос. Этого хватает, чтобы понять, тянет ли модель твою задачу, и стоит ли вкладываться дальше.
Отдельно про лимиты. Длинная выгрузка съедает контекст, и ближе к концу файла модель начинает терять его начало. Практичный порог нащупывается опытом: поплыли ответы - сворачивай данные до дневных агрегатов и укрупнённых категорий. Стоимость запросов в такой схеме обычно копеечная относительно часа работы человека, так что экономить на подробности вопроса смысла нет.
Следующий уровень - таблица. Выгрузка обновляется по расписанию, модель получает её вместе с шаблоном отчёта, отчёт падает тебе в мессенджер. Здесь уже нужен связующий инструмент, и чаще всего это визуальные сценарии: освоить n8n с нуля реально за несколько вечеров, а типовой сценарий «выгрузка - модель - сообщение» собирается из трёх узлов.
Дальше начинается территория ИИ-агентов, которые сами ходят в базу, сами выбирают срез и сами дёргают тебя при аномалии. Переходить туда стоит после того, как ручной контур отработал пару месяцев и ты знаешь, какие вопросы задаёшь регулярно.
Выбор конкретной модели решается позже и легче, чем кажется. Сильные модели считают сопоставимо, разница вылезает в длине контекста, работе с файлами и умении писать код для расчёта. Сравнение популярных вариантов под задачи бизнеса есть в материале Claude или ChatGPT: что выбрать.
Долго ли собирать ИИ-аналитика и не проще ли нанять человека?
«Это долго собирать». Смотря что считать сборкой. Первый рабочий контур состоит из одного файла, одного регламента и одного вопроса, и уже на этой пробе видно, тянет модель твою задачу или нет. Сроки зависят от состояния данных: чистая выгрузка из одного сервиса и таблицы, разбросанные по пяти системам, дают разные истории. База, дашборды и автоматизация приходят потом, когда стало понятно, что оно нужно.
«Проще нанять живого аналитика». Одно другому не мешает. Модель снимает рутину сборки и первичного счёта, человек тратит время на интерпретацию и решение. У маленькой команды отдельного аналитика обычно нет вовсе, и роль закрывает разрыв между «данных много» и «руки не доходят посмотреть».
«У меня слишком мало данных». Тогда и анализировать особо нечего, зато порог входа минимальный: пара сотен строк отлично влезает в чат целиком, и ответ проверяется глазами за минуту. Малому бизнесу обычно больше даёт регулярность взгляда на цифры, чем глубина анализа, и про это есть отдельный разбор с чего начать малому бизнесу.
«Она же врёт, зачем такое в работе». Врёт она предсказуемо, в известных местах, и лечится это процедурой проверки из третьего шага. Человек-аналитик тоже ошибается, просто его промахи разбирают на планёрке и никто не списывает их на технологию.
«Мне нужен нормальный дашборд». Дашборд отвечает на вопросы, которые ты придумал заранее, и это его сильная сторона в регулярной отчётности. Модель хороша ровно в тех случаях, когда вопрос возник только что и городить под него отдельный отчёт никто не станет.
«Данные лежат в 1С, туда ничего не подключить». На старте подключаться и не требуется: выгрузка в Excel есть в любой конфигурации, дальше работает обычный файл. Прямая интеграция обсуждается позже, когда ручная выгрузка начинает раздражать своей регулярностью.
«Нам нужна повторяемость для отчётности перед собственником». Тогда расчёт живёт в формулах таблицы или в SQL, а модель отвечает за интерпретацию и текст. Схема, где число считает детерминированный запрос, а нейросеть объясняет его и ищет аномалии, снимает главный риск и оставляет пользу.
«Проще заказать готовое решение». Разница между своей сборкой и подрядом сводится к тому, кто держит регламент и правит его после каждого промаха; выбор между этими вариантами я разбирал в материале ИИ-агенты под ключ или собрать самому.
С чего начать сборку ИИ-аналитика?
Подключение к базам оставь на потом. Достаточно одного файла и одного вопроса.
- Выгрузи продажи за квартал в CSV, приведи даты и названия колонок в порядок.
- Дай модели регламент аналитика: метрика, период, разрез, формула к каждой цифре, право сказать «данных нет».
- Задай один сильный вопрос из таблицы выше.
- Потребуй отчёт по шаблону, включая раздел «чего в данных нет».
- Сверь главную цифру руками и запиши, где модель промахнулась.
Пятый пункт со временем становится самым ценным: из списка промахов вырастает твой личный регламент, который закрывает эти дыры заранее. Если непонятно, какую задачу отдать роли первой, посмотри разбор с каких задач начинать автоматизацию рутины - логика выбора там та же.
Разборы таких связок, готовые промпты для роли аналитика и шаблоны цифровых сотрудников мы выкладываем в закрытый канал ИИмперии, можно взять готовое и адаптировать под свои данные.
Выигрывает тот, у кого собрана машина: данные, регламент, шаблон, проверка. Мощность модели решает куда меньше, чем этот каркас вокруг неё, и новый инструмент просто встаёт на готовое место, когда выходит очередная версия.
Источники
- Медиана (статистика) - Википедия - почему среднее скрывает разброс и зачем рядом смотреть медиану.
- Correlation does not imply causation - Wikipedia - о разнице между совпадением и причиной, на которой модель часто спотыкается.
- Парадокс Симпсона - Википедия - как разрез по группам переворачивает вывод, сделанный по общей сумме.
- Федеральный закон № 152-ФЗ «О персональных данных» - рамка, по которой решается, что можно выгружать в сторонний сервис.
Частые вопросы
Можно ли доверять нейросети считать выручку и метрики?
Считать - да, если она работает с выгрузкой и показывает формулу и SQL. Слепо принимать итог без сверки хотя бы одной цифры руками - нет.
Какие данные можно загружать в модель?
Обезличенные: агрегаты, метрики, суммы без имён и контактов клиентов. Персональные данные и платёжные реквизиты в облачную модель не грузим.
Нужен ли аналитик-человек, если есть ИИ-аналитик?
Да. Модель считает и подкидывает гипотезы. Но видеть картину целиком и знать, где нажать - это на тебе, и это не делегируется.
С чего начать, если данные разбросаны по разным сервисам?
Собери одну выгрузку в таблицу (CSV) по нужному периоду. Один чистый источник даёт больше, чем пять подключённых, но грязных.
Сколько строк выдержит модель в одном файле?
Зависит от инструмента, но правило простое: чем крупнее агрегат, тем надёжнее ответ. Сырой лог на сотни тысяч строк лучше сначала свернуть до дней и категорий, а потом уже спрашивать.
Что делать, если модель каждый раз считает метрику по-разному?
У тебя нет зафиксированного определения метрики. Пропиши в регламенте, что считается выручкой, что заказом и какой период берётся, и подавай этот текст в начале каждой сессии.